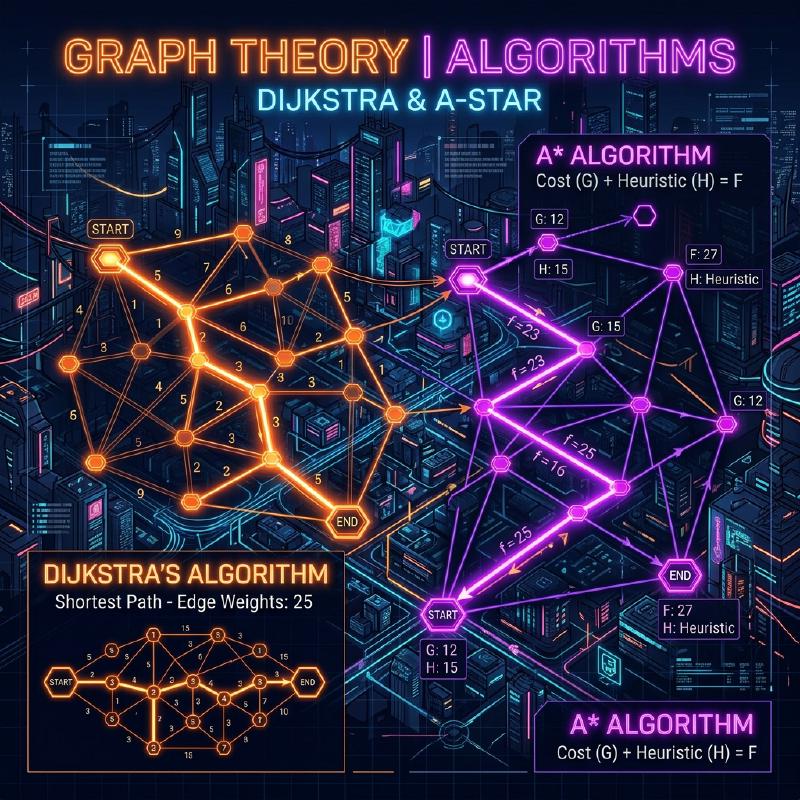
1. Einleitung
In der modernen Informatik bietet die Graphentheorie (Graph Theory) einen mächtigen mathematischen Rahmen zur Modellierung von Netzwerkstrukturen. In unserem Alltag wird die Technologie zur Berechnung des „kürzesten Weges“ in verschiedenen Situationen eingesetzt, etwa bei der Autonavigation, der Umsteigeauskunft bei der Bahn, dem Internet-Routing und sogar bei der Pfadfindung in der Spiel-KI.
In diesem Artikel erklären wir umfassend die mathematische Definition der Graphentheorie, die die Grundlage dieser Pfadfindung bildet, sowie die Mechanismen, mathematischen Beweise und praktischen Implementierungsmethoden in Python für den Dijkstra-Algorithmus (Dijkstra’s Algorithm), einen repräsentativen Suchalgorithmus, und den weiterentwickelten A-Algorithmus* (A-Star Algorithm).
2. Grundlagen der Graphentheorie
Bevor wir zu den Algorithmen kommen, definieren wir zunächst mathematisch den Graphen, der die Zieldatenstruktur darstellt.
2.1 Mathematische Definition eines Graphen
Ein Graph $ G $ wird durch ein Paar aus einer Menge von Knoten (Vertex/Node) $ V $ und einer Menge von Kanten (Edge) $ E $ definiert.
$$ G = (V, E) $$Hierbei verbindet ein Element $ e $ der Kantenmenge $ E $ zwei Knoten $ u, v \in V $ und wird als $ e = (u, v) $ ausgedrückt.
- Ungerichteter Graph (Undirected Graph): Ein Graph ohne Kantenrichtung. Wenn $ (u, v) \in E $, dann gilt auch $ (v, u) \in E $.
- Gerichteter Graph (Directed Graph): Ein Graph mit Kantenrichtung. $ (u, v) $ und $ (v, u) $ werden unterschieden.
2.2 Gewichteter Graph (Weighted Graph)
Bei der tatsächlichen Pfadfindung müssen Entfernung, Zeit, Kosten usw. berücksichtigt werden. Daher betrachten wir einen gewichteten Graphen, bei dem jeder Kante ein „Gewicht“ (Weight) zugewiesen wird. Wenn wir die Gewichtsfunktion $ w: E \rightarrow \mathbb{R} $ einführen, wird der Graph als $ G = (V, E, w) $ definiert.
$$ w(u, v) \ge 0 $$Da Entfernungen und Zeiten in vielen Fällen nicht negativ werden können, nehmen wir an, dass die Kantengewichte nicht-negativ sind.
  graph LR
    A(("A")) -->|"4"| B(("B"))
    A -->|"2"| C(("C"))
    B -->|"5"| D(("D"))
    C -->|"1"| B
    C -->|"8"| D
    C -->|"10"| E(("E"))
    D -->|"2"| E
    D -->|"6"| Z(("Z"))
    E -->|"3"| Z
Das obige Diagramm ist ein Beispiel für einen gewichteten gerichteten Graphen von Knoten $ A $ bis $ Z $. Die Zahlen auf den Kanten stellen die Kosten (Gewicht) dar.
2.3 Formulierung des Kürzeste-Wege-Problems
Ein Pfad (Path) $ P $ von einem Startknoten (Source) $ s \in V $ zu einem Zielknoten (Target) $ t \in V $ sei eine Folge von Knoten $ (v_0, v_1, \dots, v_k) $ (wobei $ v_0 = s, v_k = t $), und für jedes $ i $ gilt $ (v_i, v_{i+1}) \in E $. Die Gesamtkosten $ W(P) $ dieses Pfades $ P $ werden durch die Summe der Kantengewichte auf dem Pfad dargestellt.
$$ W(P) = \sum_{i=0}^{k-1} w(v_i, v_{i+1}) $$Das Kürzeste-Wege-Problem (Shortest Path Problem) ist das Problem, unter allen möglichen Pfaden $ P $ den Pfad $ P^* $ zu finden, der $ W(P) $ minimiert.
3. Dijkstra-Algorithmus (Dijkstra’s Algorithm)
Der von Edsger W. Dijkstra erdachte Dijkstra-Algorithmus ist ein Algorithmus, um in Graphen mit nicht-negativen Gewichten den kürzesten Weg von einem einzelnen Startknoten zu allen anderen Knoten zu finden.
3.1 Intuitives Verständnis des Algorithmus
Der Dijkstra-Algorithmus basiert auf einem Greedy-Algorithmus (Greedy Algorithm), der „nacheinander die am nächsten liegenden, noch nicht fixierten Knoten vom Startpunkt aus fixiert“.
- Bereite ein Array vor, das die vorläufigen Entfernungen vom Startpunkt speichert, und initialisiere den Startpunkt mit
0und alle anderen mitUnendlich( $ \infty $ ). - Wähle unter den noch nicht fixierten Knoten den Knoten $ u $ mit der minimalen vorläufigen Entfernung und markiere ihn als „fixiert“.
- Für alle Knoten $ v $, die benachbart zu Knoten $ u $ sind, aktualisiere die Entfernung, falls der Weg über $ u $ eine kürzere vorläufige Entfernung ergibt (diese Operation wird als Relaxation (Relaxation) bezeichnet).
- Wiederhole die Schritte 2 bis 3, bis alle Knoten fixiert sind oder der Zielknoten fixiert ist.
3.2 Mathematische Darstellung der Relaxation (Relaxation)
Die Operation zur Relaxation der Kante von Knoten $ u $ nach $ v $ wird mathematisch wie folgt ausgedrückt. Hierbei gibt $ d[v] $ die aktuelle vorläufige kürzeste Entfernung vom Startpunkt zu $ v $ an.
$$ \text{wenn } d[u] + w(u, v) < d[v]: \\\\ d[v] = d[u] + w(u, v) $$3.3 Implementierung des Dijkstra-Algorithmus in Python
Für eine effiziente Implementierung verwenden wir eine Prioritätswarteschlange (Priority Queue) als Datenstruktur, um den minimalen Wert abzurufen. In Python kann das Modul heapq verwendet werden.
| |
3.4 Über die Zeitkomplexität
Wenn wir einen binären Heap (Binary Heap) als Prioritätswarteschlange verwenden, wird jeder Knoten einmal aus der Warteschlange entnommen und jede Kante wird einmal relaxiert. Daher beträgt die Zeitkomplexität $ O((|V| + |E|) \log |V|) $. Wenn ein Fibonacci-Heap verwendet wird, kann dies theoretisch auf $ O(|E| + |V| \log |V|) $ verbessert werden, aber in der Praxis wird oft ein binärer Heap verwendet.
4. A*-Algorithmus (A-Star Algorithm)
Der Dijkstra-Algorithmus ist zuverlässig, aber da er die Suche in alle Richtungen ausdehnt, ohne die Richtung des Ziels zu berücksichtigen, kann es zu vielen unnötigen Suchvorgängen kommen. Dies wird durch den A-Algorithmus* gelöst.
4.1 Einführung der Heuristikfunktion
Der A*-Algorithmus priorisiert die Suche in Richtung des Ziels, indem er die „geschätzte Entfernung“ vom aktuellen Knoten zum Ziel verwendet. Eine Funktion, die diese geschätzte Entfernung zurückgibt, wird als Heuristikfunktion (Heuristic Function) $ h(n) $ bezeichnet.
In A* definieren wir die Funktion $ f(n) $ zur Bewertung des Knotens $ n $ wie folgt:
$$ f(n) = g(n) + h(n) $$Hierbei gilt:
- $ g(n) $: Tatsächliche Kosten vom Startpunkt zum Knoten $ n $ (wie die Entfernung beim Dijkstra-Algorithmus)
- $ h(n) $: Geschätzte Kosten vom Knoten $ n $ zum Ziel (Heuristik)
- $ f(n) $: Geschätzte Gesamtkosten des Pfades vom Startpunkt über $ n $ zum Ziel
4.2 Bedingungen für die Heuristik
Damit A* immer den kürzesten Weg findet (Optimalität), muss die Heuristikfunktion $ h(n) $ die folgenden Bedingungen erfüllen.
- $$
h(n) \le h^*(n)
$$
(wobei $ h^*(n) $ die wahren kürzesten Kosten von $ n $ zum Ziel sind)
- $$
h(m) \le c(m, n) + h(n)
$$
Hierbei sind $ c(m, n) $ die Kosten der Kante von $ m $ nach $ n $. Eine konsistente Heuristik ist automatisch zulässig.
4.3 Repräsentative Heuristikfunktionen
Für die Pfadfindung in einem Gitter werden häufig die folgenden Distanzfunktionen verwendet:
- Manhattan-Distanz (Manhattan Distance): Wenn Bewegungen nur nach oben, unten, links und rechts möglich sind $$ h(n) = |x_n - x_{goal}| + |y_n - y_{goal}| $$
- Euklidische Distanz (Euclidean Distance): Wenn eine geradlinige Bewegung in beliebige Richtungen möglich ist $$ h(n) = \sqrt{(x_n - x_{goal})^2 + (y_n - y_{goal})^2} $$
4.4 Python-Implementierung des A*-Algorithmus
Die Implementierung von A* ist der des Dijkstra-Algorithmus sehr ähnlich, außer dass der Schlüssel für die Prioritätswarteschlange $ f(n) $ ist.
| |
4.5 Vergleich zwischen Dijkstra-Algorithmus und A*
Das folgende Mermaid-Diagramm ist ein visueller Vergleich der Suchbereiche zwischen Dijkstra und A*. Während der Dijkstra-Algorithmus die Suche konzentrisch ausdehnt, erweitert A* die Suche in einer elliptischen Form, die in Richtung des Ziels gestreckt ist.
  graph TD
    subgraph "Dijkstra"
        S1(("Start")) --> A1((" "))
        S1 --> B1((" "))
        S1 --> C1((" "))
        A1 --> D1((" "))
        B1 --> Goal1(("Goal"))
        C1 --> E1((" "))
        style S1 fill:#4a9,stroke:#333
        style Goal1 fill:#f94,stroke:#333
    end

    subgraph "A_Star"
        S2(("Start")) --> B2((" "))
        B2 --> Goal2(("Goal"))
        style S2 fill:#4a9,stroke:#333
        style Goal2 fill:#f94,stroke:#333
    end
5. Anwendungen der Pfadfindung und zukünftige Perspektiven
Obwohl der Dijkstra-Algorithmus und der A*-Algorithmus grundlegende Methoden sind, bilden sie die Basis für viele angewandte Technologien.
- Bidirektionale Suche (Bidirectional Search): Eine Methode, die die Suche gleichzeitig von Start- und Zielpunkt aus durchführt und in der Mitte zusammentrifft, wodurch der Suchraum drastisch reduziert wird.
- D-Algorithmus* (Dynamic A*): Eine Methode zur effizienten Neuberechnung von Pfaden in Umgebungen, in denen unbekannte Hindernisse dynamisch auftreten (z. B. autonomes Fahren von Robotern).
- JPS (Jump Point Search): Eine Methode zur weiteren Beschleunigung der A*-Suche auf gleichmäßigen Gitterkarten. Sie nutzt Symmetrien aus, um unnötige Knoten zu überspringen.
Pfadfindungsalgorithmen sind ein Bereich, in dem die mathematische Schönheit der Graphentheorie und die algorithmische Effizienz der Informatik brillant verschmelzen.
6. Fazit
In diesem Artikel haben wir von den grundlegenden Definitionen der Graphentheorie über die mathematischen Hintergründe und spezifischen Mechanismen des Dijkstra-Algorithmus und des A*-Algorithmus bis hin zu Beispielen ihrer Implementierung in Python alles erklärt.
- Der Dijkstra-Algorithmus bewertet alle Knoten gleichmäßig und garantiert zuverlässig den kürzesten Weg.
- Der A-Algorithmus* erreicht durch die Einführung einer Heuristikfunktion $ h(n) $ eine effiziente Suche in Richtung des Ziels.
Dieses Wissen beschränkt sich nicht nur auf das Verständnis von Algorithmen, sondern wird auch zu einem mächtigen Denkwerkzeug, um komplexe reale Probleme in mathematische Modelle von „Graphen“ zu übersetzen und optimale Lösungen abzuleiten. Bitte lassen Sie den tatsächlichen Code laufen und erleben Sie seine Leistungsfähigkeit selbst.