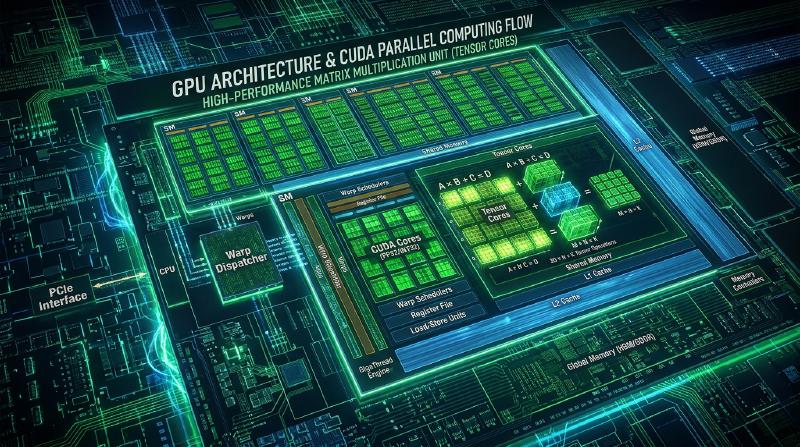
GPU-Massivparallelarchitektur und die Physik von CUDA: Die Berechnungsprinzipien von SIMT, Warp und Tensor-Cores
Die grundlegende Technologie, die die moderne fortgeschrittene Computerwissenschaft, künstliche Intelligenz, Deep Learning und hochauflösende Computergrafik unterstützt, ist die GPU (Graphics Processing Unit). In diesem Artikel werden wir tief in die physikalischen und Hardware-Aspekte der GPU-Architektur und der darauf basierenden parallelen Berechnungsplattform CUDA (Compute Unified Device Architecture) eintauchen. Anstatt nur Programmiersyntax zu behandeln, werden wir gründlich analysieren, “warum die Hardware so entworfen ist” und “wie sie extremen Berechnungsdurchsatz erreicht”, und zwar aus der Perspektive von Streaming Multiprocessors (SM), dem SIMT-Ausführungsmodell, Warp-Scheduling, Tensor-Cores und der Speicherhierarchie.
Kapitel 1: Der Wendepunkt in der Designphilosophie von CPUs und GPUs
1.1 Streben nach niedriger Latenz vs. Streben nach hohem Durchsatz
Die Designphilosophien einer Allzweck-CPU (Central Processing Unit) und einer für parallele Berechnungen optimierten GPU unterscheiden sich aufgrund ihrer Entstehungsgeschichte grundlegend. Die CPU hat sich mit dem obersten Ziel der “niedrigen Latenz (Minimierung von Verzögerungen)” entwickelt: “Wie kann eine einzige Aufgabe (Thread) so schnell wie möglich beendet werden”. Die GPU hingegen strebt nach “hohem Durchsatz (Maximierung der Verarbeitungsmenge)”: “Wie viel Verarbeitung kann pro Zeiteinheit abgeschlossen werden, indem eine große Menge von Aufgaben gebündelt wird”.
CPUs müssen unvorhersehbare Aufgaben wie die Steuerung des Betriebssystems, die Ausführung von Anwendungen mit komplexen Verzweigungsbedingungen und zufällige Interrupt-Verarbeitungen durch Benutzer schnell bewältigen. Daher sind sie mit hochentwickelten Sprungvorhersageschaltkreisen, Out-of-Order-Ausführung (einem Mechanismus zum Ausführen von Anweisungen in geänderter Reihenfolge) und riesigen L1/L2/L3-Cache-Speichern ausgestattet, wodurch sie Speicherzugriffsverzögerungen verbergen und die Leistung einzelner Threads auf das Äußerste maximieren.
Im Gegensatz dazu wurden GPUs ursprünglich entwickelt, um hochgradig parallelisierbare Aufgaben zu verarbeiten, wie etwa die Anwendung derselben Shading-Operation auf Millionen von Pixeln auf dem Bildschirm. Anstatt Chipfläche für komplexe Steuerschaltungen und riesige Caches zu opfern, haben sie sich dafür entschieden, einfache Recheneinheiten (ALUs: Arithmetic Logic Units) bis an die Grenzen aufzureihen.
1.2 Verteilungsverhältnis von Cache, Steuerschaltungen und ALUs auf der Chipfläche
Wie die begrenzte Fläche (das Transistorbudget) des Silizium-Dies (Halbleiterchips) verteilt wird, bestimmt den Unterschied in der Architektur der beiden.
- CPU-Chipflächenverteilung: Mehr als die Hälfte des Chips wird von großen Cache-Speichern (SRAM) und hochentwickelten Steuerschaltungen (Sprungvorhersage, Befehlsabruf, Dekodierung, Scheduling usw.) eingenommen. Der Anteil der ALUs, die die eigentlichen Berechnungen durchführen, ist relativ klein.
- GPU-Chipflächenverteilung: Cache-Speicher und Steuerschaltungen sind auf das absolute Minimum beschränkt, und der größte Teil des Chips wird von Tausenden bis Zehntausenden von ALUs (CUDA-Cores) eingenommen.
Die GPU verbirgt Speicherzugriffsverzögerungen (Latenz) nicht mit einem Cache, sondern durch “Kontextwechsel”. Während eine Thread-Gruppe auf das Eintreffen von Daten aus dem Speicher wartet, führt sie sofort die Berechnungen einer anderen Thread-Gruppe aus und hält so die Recheneinheiten ständig im Betriebszustand (hohe Auslastung: Occupancy). Dies ist die physische Implementierung des “Strebens nach hohem Durchsatz” in einer GPU. Da Hardware-Multithreading auf Hardwareebene extrem leichtgewichtig durchgeführt wird, wird davon ausgegangen, dass Tausende bis Zehntausende von parallelen Threads vorhanden sind.
Kapitel 2: Die Essenz des SIMT-Ausführungsmodells
2.1 Der Unterschied zwischen SIMD und SIMT
Als Klassifizierung für Parallelverarbeitung gibt es die Flynn’sche Taxonomie (Flynn’s taxonomy), aber das GPU-Ausführungsmodell wird oft mit SIMD (Single Instruction, Multiple Data) verglichen. Vektorerweiterungsbefehle von CPUs (wie AVX) sind reines SIMD und verarbeiten mehrere Daten (z. B. acht 32-Bit-Fließkommazahlen, die in einem 256-Bit-breiten Register gespeichert sind) gleichzeitig mit einer einzigen Anweisung. Bei SIMD ist es sehr schwierig, unterschiedliche Verzweigungen (if-else) für jedes Datenelement durchzuführen.
Andererseits wird das von NVIDIA vorgeschlagene CUDA-Ausführungsmodell als SIMT (Single Instruction, Multiple Threads) bezeichnet. Bei SIMT bilden mehrere unabhängige “Threads” eine Gruppe (einen “Warp”, der später beschrieben wird) und teilen sich dieselbe Anweisung, um sie auszuführen. Im Gegensatz zu SIMD hat jedoch jeder Thread in SIMT einen unabhängigen Registerstatus und einen Anweisungsadresszähler (im Programmiermodell). Dies ermöglicht es Programmierern, Code so zu schreiben, als ob jeder Thread unabhängig arbeiten würde.
2.2 Der “Warp” in 32-Thread-Einheiten
Die GPU-Hardware plant Threads nicht einzeln, sondern verwaltet und führt sie in Einheiten von 32 Threads zusammengefasst, die “Warp” genannt werden, aus. (In AMD-GPUs wird dies Wavefront genannt, und manchmal werden Einheiten von 64 Threads verwendet).
Die Befehlsabruf- und Dekodierungseinheit innerhalb eines Streaming Multiprocessors (SM) ruft eine Anweisung pro Warp ab und gibt (dispatch) dieselbe Anweisung an alle 32 Threads im Warp aus. Das bedeutet, dass die 32 Threads in einem Warp physisch exakt gleichzeitig dieselbe Anweisung auf ihren jeweils unterschiedlichen Daten ausführen. Das ist der Kern von SIMT.
2.3 Die physische Strafe von Warp-Divergenz
Obwohl es so aussieht, als hätte jeder Thread einen unabhängigen Programmzähler, müssen physisch alle Threads in einem Warp dieselbe Anweisung ausführen. Was passiert also, wenn es eine bedingte Verzweigung wie if-else im Code gibt und sich die Wahrheitswerte der Verzweigungsbedingung unter den Threads in einem Warp unterscheiden?
Dieses Phänomen wird als Warp-Divergenz (Warp Divergence) bezeichnet.
Wenn eine Warp-Divergenz auftritt, führt die Hardware die Verarbeitung in den folgenden Schritten durch:
- Zuerst wird der Befehl nur für die Threads ausgeführt, bei denen die
if-Bedingung wahr war (aktive Threads). Zu diesem Zeitpunkt werden die Threads, bei denen die Bedingung falsch war, “maskiert” (deaktiviert), und die Berechnungsergebnisse werden nicht geschrieben. - Als nächstes geht sie zum
else-Pfad (oder dem Pfad, wenn die Bedingung falsch ist) über. Dieses Mal aktiviert sie die zuvor maskierten Threads, maskiert die Threads, die wahr waren, und führt den Befehl aus.
Das heißt, wenn es mehrere Verzweigungspfade gibt, ist die Hardware gezwungen, diese Pfade seriell statt parallel auszuführen. Als extremes Beispiel: Wenn die 32 Threads in einem Warp 32 unterschiedliche Verzweigungspfade durchlaufen, springt die Ausführungszeit um das 32-fache in die Höhe. Warp-Divergenz ist einer der größten Faktoren, der den Berechnungsdurchsatz einer GPU drastisch reduziert, und das am stärksten zu vermeidende Anti-Pattern im Algorithmus-Design. Physikalisch bedeutet dies, dass obwohl die ALUs Strom verbrauchen, “verschwendete Zyklen” auftreten, da sie keine gültigen Berechnungsergebnisse erzeugen, weil sie maskiert sind.
Kapitel 3: Hardware-Anatomie des Streaming Multiprocessors (SM)
Die GPU ist als Ansammlung zahlreicher Streaming Multiprocessors (SM) aufgebaut. Der SM ist die wahre Berechnungsmaschine der GPU. In der neuesten Architektur (z.B. Hopper H100) sind über 100 SMs auf einem einzigen GPU-Die untergebracht.
3.1 Die Pipeline-Struktur im Inneren des SM
Ein SM ist intern weiter in mehrere Unterpartitionen (normalerweise 4) unterteilt, von denen jede einen unabhängigen Warp-Scheduler und eine Dispatch-Einheit hat.
- Warp-Scheduler (Warp Scheduler): Wählt Warps aus, die sich in einem ausführbaren Zustand befinden (bei denen Register und Speicher vorbereitet sind). Der GPU-Scheduler kann Warps mit null Overhead umschalten, und dies ist der Schlüssel zum Verbergen der Speicherzugriffslatenz.
- Dispatch-Einheit (Dispatch Unit): Gibt Befehle an den geplanten Warp aus.
- CUDA-Core (INT32 / FP32 / FP64 ALU): Die Einheit, die tatsächliche Ganzzahl- oder Fließkommaberechnungen durchführt.
- Load/Store-Einheit (LD/ST Unit): Zuständig für das Lesen und Schreiben in den Speicher.
- Special Function Unit (SFU): Spezielle Hardware zur schnellen Berechnung transzendenter Funktionen wie Sinus, Kosinus, Exponentialfunktionen und Kehrwerten.
Die Befehlspipeline ist sehr tief konzipiert und verfügt über Phasen für Abruf, Dekodierung, Scheduling, Registerlesevorgänge, Ausführung (mehrere Zyklen) und Write-Back. Die Latenz einer FP32-FMA-Berechnung (Fused Multiply-Add) dauert normalerweise mehrere bis über zehn Zyklen, aber indem in jedem Zyklus Befehle von einem anderen Warp ausgegeben werden, wird die Pipeline stets voll gehalten.
3.2 Riesige Registerdatei und Registerdruck
Ein SM ist mit einer Registerdatei ausgestattet, die unvergleichlich größer ist als die einer CPU (z. B. 64 KB bis 256 KB SRAM pro SM). Dies dient dazu, den Kontext aller Tausenden von Threads, die gleichzeitig auf dem SM ausgeführt werden, beizubehalten.
Ein Kontextwechsel wird in null Zyklen abgeschlossen, weil es nicht notwendig ist, den Registerstatus eines Threads in den Speicher auszulagern (Spilling). Wenn jedoch die Anzahl der pro Thread verwendeten Register steigt, sinkt die Anzahl der Warps, die gleichzeitig innerhalb eines SM gestartet werden können (Occupancy). Dies wird als Registerdruck (Register Pressure) bezeichnet. Wenn die Register erschöpft sind, werden die Daten in den langsameren lokalen Speicher (physisch ein Teil des globalen Speichers) ausgelagert, was zu einem katastrophalen Leistungsabfall führt.
3.3 Gemeinsam genutzter Speicher (Shared Memory) und Bankkonflikte
Ein SM verfügt über Shared Memory, einen ultraschnellen On-Chip-Speicher, der vom Programmierer explizit gesteuert werden kann. Er teilt denselben physischen SRAM-Bereich mit dem L1-Cache, fungiert jedoch als expliziter Daten-Cache und wird zur gemeinsamen Nutzung von Daten und zur Synchronisation zwischen Threads innerhalb eines Blocks verwendet.
Die physische Struktur des Shared Memory ist in mehrere unabhängige Module (normalerweise 32) unterteilt, die Speicherbanken (Memory Banks) genannt werden. Aufeinanderfolgende 32-Bit-Adressen werden verschachtelt (interleaved) auf verschiedene Banken verteilt.
Wenn die 32 Threads in einem Warp gleichzeitig auf verschiedene Banken zugreifen, wird der Zugriff vollständig parallel (in 1 Zyklus) verarbeitet. Dies wird als bankkonfliktfrei bezeichnet. Wenn jedoch mehrere Threads gleichzeitig auf verschiedene Adressen in derselben Bank zugreifen wollen, werden die Anforderungen serialisiert und es entsteht eine Strafe (Verzögerung). Dies wird als Bankkonflikt (Bank Conflict) bezeichnet. Bei einem 2-Wege-Bankkonflikt verdoppelt sich beispielsweise die Zugriffszeit, und im schlimmsten Fall, einem 32-Wege-Konflikt, verzögert sie sich um das 32-fache. In Algorithmen wie der Matrixtransposition verursachen Stride-Zugriffe schwerwiegende Bankkonflikte. Daher sind fortgeschrittene Optimierungen mithilfe von Padding (einer Technik zum Einfügen von Dummy-Daten zum Verschieben von Speicheradressen) unerlässlich, um Konflikte zu vermeiden.
Kapitel 4: Die Multiply-Accumulate-Pipeline des Tensor-Cores
Die revolutionäre Hardware, die zuerst mit der Volta-Architektur eingeführt wurde und die GPU-Leistung seitdem dramatisch gesteigert hat, ist der Tensor-Core. Die explosive Entwicklung der KI und des Deep Learning wäre ohne Tensor-Cores undenkbar.
4.1 Hardware-Implementierung von Matrix-Multiply-Accumulate (MMA)
Der Großteil der Berechnungen beim Deep Learning besteht aus Matrixmultiplikationen (GEMM: General Matrix Multiply) von Gewichtsmatrizen neuronaler Netze und Eingabedaten. Die Berechnungsformel wird als $D = A \times B + C$ ausgedrückt (wobei $A, B$ Eingabematrizen und $C$ eine Akkumulatormatrix sind).
In herkömmlichen CUDA-Cores wurde dieses Matrixprodukt Element für Element unter Verwendung von FMA-Befehlen (Fused Multiply-Add) berechnet. Im Gegensatz dazu ist der Tensor-Core eine dedizierte Schaltung, die Multiply-Accumulate-Operationen auf kleinen Matrizen (z. B. 4x4 oder 16x16) auf Hardwareebene in einem einzigen Zyklus (oder wenigen Zyklen) ausführt.
Physikalisch werden Dutzende bis Hunderte von Multiplikatoren und ein riesiger Additionsbaum direkt mit Drähten verbunden, wodurch die Multiply-Accumulate-Operation in einem Rutsch abgeschlossen wird, ohne dass Zwischenergebnisse in Register zurückgeschrieben werden müssen. Infolgedessen ist der Berechnungsdurchsatz (TFLOPS) pro Fläche im Vergleich zu normalen CUDA-Cores um Größenordnungen höher.
4.2 Die Geheimnisse der Mixed-Precision
Eine weitere Essenz des Tensor-Cores ist die Unterstützung für Mixed-Precision-Berechnungen. Beim Deep Learning gibt es viele Situationen im Berechnungsprozess, die keine hohe Präzision (FP32/FP64) erfordern. Der Tensor-Core verfügt über eine Pipeline, die die Eingabematrizen $A$ und $B$ mit niedriger Präzision (FP16, BF16 oder sogar noch niedriger FP8, INT8, INT4) einliest, interne Multiplikationen mit niedriger Präzision durchführt und dann den Additions-(Akkumulations-)Prozess mit höherer Präzision (FP32 oder INT32) durchführt.
- FP16 / BF16: Der Standard für das Training. BF16 (Bfloat16) hat denselben 8-Bit-Exponenten wie FP32 und einen weiten Dynamikbereich, wodurch sich das Problem des verschwindenden Gradienten leicht verhindern lässt.
- FP8 / INT8 / INT4: Der Trumpf zur Beschleunigung der Inferenz. Da das Datenübertragungsvolumen (Speicherbandbreite) ebenfalls reduziert wird, verbessert sich der Durchsatz drastisch.
Die Hopper-Architektur führte den “FP8 Tensor Core” ein, der die Berechnungen für Transformer-Modelle dramatisch beschleunigt und theoretisch im Vergleich zu FP32 einen dutzendfach höheren Durchsatz erreicht. Von der Softwareseite (CUDA) wird der Tensor-Core direkt über die wmma (Warp-Level Matrix Multiply and Accumulate) API oder die mma.sync PTX-Anweisung angesteuert. Dabei wird eine extrem komplexe kollektive Verarbeitung durchgeführt, bei der die Threads in einem Warp kooperieren, um Matrixfragmente in Register zu laden, zu berechnen und zu speichern.
Kapitel 5: CUDA-Speicherhierarchie und Optimierungstechniken
Egal wie hoch die Rechenleistung einer GPU ist, die Leistung wird leiden, wenn die Datenversorgung zum Flaschenhals wird (die “Memory Wall”). Es ist keine Übertreibung zu sagen, dass 90 % der Optimierungen in der CUDA-Programmierung “Speicherzugriffsoptimierungen” sind.
5.1 Coalesced Access zum globalen Speicher
Der globale Speicher, der der Hauptspeicher (HBM oder GDDR) der GPU ist, hat eine sehr große Bandbreite (z. B. mehrere TB/s), aber auch eine sehr hohe Latenz von Hunderten von Zyklen.
Das absolute Prinzip zur Maximierung der Zugriffseffizienz auf den globalen Speicher ist Coalescing (Zusammenfassung). Der Speichercontroller der GPU greift auf den Speicher in Transaktionseinheiten von 32 Byte, 64 Byte oder 128 Byte zu. Wenn die 32 Threads in einem Warp auf den Speicher zugreifen und ihre Speicheradressen in einen zusammenhängenden Bereich (innerhalb einer ausgerichteten 128-Byte-Grenze) fallen, kombiniert (coalesced) die Hardware diese Anforderungen zu einer einzigen Speichertransaktion zur Verarbeitung.
Wenn Threads stattdessen auf zufällige Adressen zugreifen oder Stride-Zugriffe (mit Abständen) durchführen, findet keine Zusammenfassung statt und es entstehen mehrere Transaktionen. Dies wird als “nicht-koaleszierter Zugriff” bezeichnet und ist ein fataler Performance-Bug, der die effektive Speicherbandbreite auf weniger als ein Zehntel reduzieren kann.
5.2 CUDA C++ Codebeispiel: Matrixtranspositionsoptimierung und Shared Memory
Das Folgende ist ein Beispiel für einen optimierten Kernelcode zur Matrixtransposition, der nicht-koaleszierten Zugriff vermeidet und Shared Memory nutzt, um die Leistung drastisch zu verbessern.
| |
Es gibt 3 Hauptpunkte in diesem Code:
- Coalescing beim Lesen: Das Lesen aus
idataerfolgt in X-Richtung, wothreadIdx.xfortlaufend ist, sodass es vollständig koalesziert wird. - Coalescing beim Schreiben: Auch das Schreiben in
odataist so konzipiert, dass es in derthreadIdx.x-Richtung fortlaufend ist, indem die Blockkoordinaten vertauscht werden, sodass es koalesziert wird. - Padding im Shared Memory: Durch eine Verschiebung (Padding) um ein Element wie in
tile[TILE_DIM][TILE_DIM + 1]werden Bankkonflikte beim Zugriff in Spaltenrichtung (tile[threadIdx.x][threadIdx.y + j]) beim Schreiben vollständig beseitigt.
5.3 Cache-Hierarchie und spezieller Speicher
- L1/L2-Cache-Richtlinien: In neueren GPU-Architekturen kann der Programmierer das Verhalten des Caches als Hinweis über PTX-Anweisungen (wie
.ca,.cg,.cs) steuern. Beispielsweise können Daten, auf die nur einmal zugegriffen wird, den L2-Cache umgehen (Streaming Access), um eine Cache-Verschmutzung zu vermeiden. - Texture Memory / Constant Memory: Der für die Bildverarbeitung optimierte Texture Memory nutzt einen speziellen Cache für Zugriffe mit 2D-räumlicher Lokalität. Der Constant Memory bietet eine extrem hohe Effizienz für Broadcast-Zugriffe, bei denen alle Threads dieselbe Konstante lesen.
Kapitel 6: Die Zukunft von GPUs im Zeitalter des Deep Learning
Die aktuelle Grenze der Computerwissenschaft ist nicht nur die Leistungssteigerung einzelner GPUs, sondern die Skalierung des gesamten Systems.
6.1 Ultraschnelle Verbindung mit NVLink und NVSwitch
Riesige LLMs (Large Language Models) passen nicht in den Speicher einer einzelnen GPU (z. B. 80 GB oder 144 GB). Um Modellparallelität (Tensor-Parallelität oder Pipeline-Parallelität) durchzuführen, müssen Terabyte an Daten pro Sekunde zwischen den GPUs ausgetauscht werden. Da der herkömmliche PCIe-Bus (PCI Express) diese Bandbreite nicht abdecken kann, hat NVIDIA einen proprietären Hochgeschwindigkeits-Interconnect namens NVLink entwickelt. Darüber hinaus ermöglicht ein Switch-Chip namens NVSwitch, dass 8 oder 256 GPUs über einen vollständig blockierungsfreien Crossbar-Switch verbunden werden, wodurch ein Cluster aufgebaut wird, der sich wie eine einzige riesige GPU verhält.
6.2 Transformer Engine und das FP8-Ökosystem
Zur Optimierung für die Transformer-Architektur, die zum De-facto-Standard nicht nur in der Verarbeitung natürlicher Sprache, sondern auch in der Bild- und Spracherkennung geworden ist, ist die Hopper-Architektur mit einem Co-Design-Mechanismus aus Hardware und Software namens Transformer Engine ausgestattet. Dieses System überwacht dynamisch Tensor-Statistiken und wechselt die Berechnungspräzision zwischen FP8 und FP16 Schicht für Schicht automatisch (Dynamic Scaling). So wird eine extreme Berechnungsgeschwindigkeit und Einsparung von Speicherbandbreite erzielt, ohne dass es zu einem Genauigkeitsverlust kommt.
6.3 Skalierungsgesetze für GPU-Cluster und Zukunftsaussichten
Wie in OpenAIs “Scaling Laws” gezeigt, verbessert sich die Leistung der KI weiter, je mehr Parameter und Rechenleistung das Modell hat. Dementsprechend entwickeln sich GPUs von bloßen Prozessoren zu dem Zustand, in dem “das Rechenzentrum selbst eine einzige riesige GPU (Supercomputer)” ist, in dem Zehntausende von Einheiten über Glasfaser verbunden sind.
Die zukünftige Architekturentwicklung wird auf die Einführung von Silizium-Photonik (optische Interconnects), CPO (Co-Packaged Optics) und eine weitere Verfeinerung von 3D-Stapeltechnologien von SRAM bis HBM zusteuern. Doch die unveränderliche DNA der GPUs seit ihrer Erfindung – “die Maximierung des Durchsatzes durch Parallelverarbeitung” – wird weiterhin die Speerspitze der Computerwissenschaft bilden.
[Zusätzliche Abhandlung] Mathematische Analyse von Scheduling und Occupancy in GPUs
title: “Die massiv parallele Architektur von Grafikprozessoren und die Physik von CUDA: Berechnungsprinzipien von SIMT, Warps und Tensor-Cores” description: “Das interne Design von Grafikprozessoren, das höchsten Durchsatz bis zum Äußersten anstrebt. Die Essenz von SMs, Warp-Scheduling, Tensor-Cores und Shared-Memory-Optimierung.” slug: “gpu-architecture-cuda-parallel-computing” date: “2026-10-03T05:00:00+09:00” categories: [“architecture”, “technology”] tags: [“gpu”, “cuda”, “parallel-computing”, “hardware”] image: “eyecatch.jpg”
Die massiv parallele Architektur von Grafikprozessoren und die Physik von CUDA: Berechnungsprinzipien von SIMT, Warps und Tensor-Cores
Die grundlegende Technologie, die die moderne fortgeschrittene Computerwissenschaft, künstliche Intelligenz, Deep Learning und hochauflösende Computergrafik unterstützt, ist der Grafikprozessor (Graphics Processing Unit). In diesem Artikel werden wir tief in die physikalischen und Hardware-Aspekte der Architektur von Grafikprozessoren und der darauf basierenden parallelen Berechnungsplattform CUDA (Compute Unified Device Architecture) eintauchen. Anstatt nur Programmiersyntax zu behandeln, werden wir gründlich analysieren, “warum die Hardware so entworfen ist” und “wie sie extremen Berechnungsdurchsatz erreicht”, und zwar aus der Perspektive von Streaming Multiprocessors (SM), dem SIMT-Ausführungsmodell, Warp-Scheduling, Tensor-Cores und der Speicherhierarchie.
Ergänzung zu Kapitel 1: Der Wendepunkt in der Designphilosophie von Allzweckprozessoren und Grafikprozessoren
1.1 Streben nach niedriger Latenz vs. Streben nach hohem Durchsatz
Die Designphilosophien eines Allzweckprozessors (Central Processing Unit) und eines für parallele Berechnungen optimierten Grafikprozessors unterscheiden sich aufgrund ihrer Entstehungsgeschichte grundlegend. Der Allzweckprozessor hat sich mit dem obersten Ziel der “niedrigen Latenz (Minimierung von Verzögerungen)” entwickelt: “Wie kann eine einzige Aufgabe (Thread) so schnell wie möglich beendet werden”. Der Grafikprozessor hingegen strebt nach “hohem Durchsatz (Maximierung der Verarbeitungsmenge)”: “Wie viel Verarbeitung kann pro Zeiteinheit abgeschlossen werden, indem eine große Menge von Aufgaben gebündelt wird”.
Allzweckprozessoren müssen unvorhersehbare Aufgaben wie die Steuerung des Betriebssystems, die Ausführung von Anwendungen mit komplexen Verzweigungsbedingungen und zufällige Interrupt-Verarbeitungen durch Benutzer schnell bewältigen. Daher sind sie mit hochentwickelten Sprungvorhersageschaltkreisen, Out-of-Order-Ausführung (einem Mechanismus zum Ausführen von Anweisungen in geänderter Reihenfolge) und riesigen L1/L2/L3-Cache-Speichern ausgestattet, wodurch sie Speicherzugriffsverzögerungen verbergen und die Leistung einzelner Threads auf das Äußerste maximieren.
Im Gegensatz dazu wurden Grafikprozessoren ursprünglich entwickelt, um hochgradig parallelisierbare Aufgaben zu verarbeiten, wie etwa die Anwendung derselben Shading-Operation auf Millionen von Pixeln auf dem Bildschirm. Anstatt Chipfläche für komplexe Steuerschaltungen und riesige Caches zu opfern, haben sie sich dafür entschieden, einfache Recheneinheiten (ALUs: Arithmetic Logic Units) bis an die Grenzen aufzureihen.
1.2 Verteilungsverhältnis von Cache, Steuerschaltungen und ALUs auf der Chipfläche
Wie die begrenzte Fläche (das Transistorbudget) des Silizium-Dies (Halbleiterchips) verteilt wird, bestimmt den Unterschied in der Architektur der beiden.
- Chipflächenverteilung des Allzweckprozessors: Mehr als die Hälfte des Chips wird von großen Cache-Speichern (SRAM) und hochentwickelten Steuerschaltungen (Sprungvorhersage, Befehlsabruf, Dekodierung, Scheduling usw.) eingenommen. Der Anteil der ALUs, die die eigentlichen Berechnungen durchführen, ist relativ klein.
- Chipflächenverteilung des Grafikprozessors: Cache-Speicher und Steuerschaltungen sind auf das absolute Minimum beschränkt, und der größte Teil des Chips wird von Tausenden bis Zehntausenden von ALUs (CUDA-Cores) eingenommen.
Grafikprozessoren verbergen Speicherzugriffsverzögerungen (Latenz) nicht mit einem Cache, sondern durch “Kontextwechsel”. Während eine Thread-Gruppe auf das Eintreffen von Daten aus dem Speicher wartet, führt sie sofort die Berechnungen einer anderen Thread-Gruppe aus und hält so die Recheneinheiten ständig im Betriebszustand (hohe Auslastung: Occupancy). Dies ist die physische Implementierung des “Strebens nach hohem Durchsatz” in einem Grafikprozessor. Da Hardware-Multithreading auf Hardwareebene extrem leichtgewichtig durchgeführt wird, wird davon ausgegangen, dass Tausende bis Zehntausende von parallelen Threads vorhanden sind.
Ergänzung zu Kapitel 2: Die Essenz des SIMT-Ausführungsmodells
2.1 Der Unterschied zwischen SIMD und SIMT
Als Klassifizierung für Parallelverarbeitung gibt es die Flynn’sche Taxonomie (Flynn’s taxonomy), aber das Ausführungsmodell von Grafikprozessoren wird oft mit SIMD (Single Instruction, Multiple Data) verglichen. Vektorerweiterungsbefehle von Allzweckprozessoren (wie AVX) sind reines SIMD und verarbeiten mehrere Daten (z. B. acht 32-Bit-Fließkommazahlen, die in einem 256-Bit-breiten Register gespeichert sind) gleichzeitig mit einer einzigen Anweisung. Bei SIMD ist es sehr schwierig, unterschiedliche Verzweigungen (if-else) für jedes Datenelement durchzuführen.
Andererseits wird das von NVIDIA vorgeschlagene CUDA-Ausführungsmodell als SIMT (Single Instruction, Multiple Threads) bezeichnet. Bei SIMT bilden mehrere unabhängige “Threads” eine Gruppe (einen “Warp”, der später beschrieben wird) und teilen sich dieselbe Anweisung, um sie auszuführen. Im Gegensatz zu SIMD hat jedoch jeder Thread in SIMT einen unabhängigen Registerstatus und einen Anweisungsadresszähler (im Programmiermodell). Dies ermöglicht es Programmierern, Code so zu schreiben, als ob jeder Thread unabhängig arbeiten würde.
2.2 Der “Warp” in 32-Thread-Einheiten
Die Hardware des Grafikprozessors plant Threads nicht einzeln, sondern verwaltet und führt sie in Einheiten von 32 Threads zusammengefasst, die “Warp” genannt werden, aus. (In AMD-Grafikprozessoren wird dies Wavefront genannt, und manchmal werden Einheiten von 64 Threads verwendet).
Die Befehlsabruf- und Dekodierungseinheit innerhalb eines Streaming Multiprocessors (SM) ruft eine Anweisung pro Warp ab und gibt (dispatch) dieselbe Anweisung an alle 32 Threads im Warp aus. Das bedeutet, dass die 32 Threads in einem Warp physisch exakt gleichzeitig dieselbe Anweisung auf ihren jeweils unterschiedlichen Daten ausführen. Das ist der Kern von SIMT.
2.3 Die physische Strafe von Warp-Divergenz
Obwohl es so aussieht, als hätte jeder Thread einen unabhängigen Programmzähler, müssen physisch alle Threads in einem Warp dieselbe Anweisung ausführen. Was passiert also, wenn es eine bedingte Verzweigung wie if-else im Code gibt und sich die Wahrheitswerte der Verzweigungsbedingung unter den Threads in einem Warp unterscheiden?
Dieses Phänomen wird als Warp-Divergenz (Warp Divergence) bezeichnet.
Wenn eine Warp-Divergenz auftritt, führt die Hardware die Verarbeitung in den folgenden Schritten durch:
- Zuerst wird der Befehl nur für die Threads ausgeführt, bei denen die
if-Bedingung wahr war (aktive Threads). Zu diesem Zeitpunkt werden die Threads, bei denen die Bedingung falsch war, “maskiert” (deaktiviert), und die Berechnungsergebnisse werden nicht geschrieben. - Als nächstes geht sie zum
else-Pfad (oder dem Pfad, wenn die Bedingung falsch ist) über. Dieses Mal aktiviert sie die zuvor maskierten Threads, maskiert die Threads, die wahr waren, und führt den Befehl aus.
Das heißt, wenn es mehrere Verzweigungspfade gibt, ist die Hardware gezwungen, diese Pfade seriell statt parallel auszuführen. Als extremes Beispiel: Wenn die 32 Threads in einem Warp 32 unterschiedliche Verzweigungspfade durchlaufen, springt die Ausführungszeit um das 32-fache in die Höhe. Warp-Divergenz ist einer der größten Faktoren, der den Berechnungsdurchsatz eines Grafikprozessors drastisch reduziert, und das am stärksten zu vermeidende Anti-Pattern im Algorithmus-Design. Physikalisch bedeutet dies, dass obwohl die ALUs Strom verbrauchen, “verschwendete Zyklen” auftreten, da sie keine gültigen Berechnungsergebnisse erzeugen, weil sie maskiert sind.
Ergänzung zu Kapitel 3: Hardware-Anatomie des Streaming Multiprocessors (SM)
Ein Grafikprozessor ist als Ansammlung zahlreicher Streaming Multiprocessors (SM) aufgebaut. Der SM ist die wahre Berechnungsmaschine des Grafikprozessors. In der neuesten Architektur (z.B. Hopper H100) sind über 100 SMs auf einem einzigen Grafikprozessor-Die untergebracht.
3.1 Die Pipeline-Struktur im Inneren des SM
Ein SM ist intern weiter in mehrere Unterpartitionen (normalerweise 4) unterteilt, von denen jede einen unabhängigen Warp-Scheduler und eine Dispatch-Einheit hat.
- Warp-Scheduler (Warp Scheduler): Wählt Warps aus, die sich in einem ausführbaren Zustand befinden (bei denen Register und Speicher vorbereitet sind). Der Scheduler des Grafikprozessors kann Warps mit null Overhead umschalten, und dies ist der Schlüssel zum Verbergen der Speicherzugriffslatenz.
- Dispatch-Einheit (Dispatch Unit): Gibt Befehle an den geplanten Warp aus.
- CUDA-Core (INT32 / FP32 / FP64 ALU): Die Einheit, die tatsächliche Ganzzahl- oder Fließkommaberechnungen durchführt.
- Load/Store-Einheit (LD/ST Unit): Zuständig für das Lesen und Schreiben in den Speicher.
- Special Function Unit (SFU): Spezielle Hardware zur schnellen Berechnung transzendenter Funktionen wie Sinus, Kosinus, Exponentialfunktionen und Kehrwerten.
Die Befehlspipeline ist sehr tief konzipiert und verfügt über Phasen für Abruf, Dekodierung, Scheduling, Registerlesevorgänge, Ausführung (mehrere Zyklen) und Write-Back. Die Latenz einer FP32-FMA-Berechnung (Fused Multiply-Add) dauert normalerweise mehrere bis über zehn Zyklen, aber indem in jedem Zyklus Befehle von einem anderen Warp ausgegeben werden, wird die Pipeline stets voll gehalten.
3.2 Riesige Registerdatei und Registerdruck
Ein SM ist mit einer Registerdatei ausgestattet, die unvergleichlich größer ist als die eines Allzweckprozessors (z. B. 64 KB bis 256 KB SRAM pro SM). Dies dient dazu, den Kontext aller Tausenden von Threads, die gleichzeitig auf dem SM ausgeführt werden, beizubehalten.
Ein Kontextwechsel wird in null Zyklen abgeschlossen, weil es nicht notwendig ist, den Registerstatus eines Threads in den Speicher auszulagern (Spilling). Wenn jedoch die Anzahl der pro Thread verwendeten Register steigt, sinkt die Anzahl der Warps, die gleichzeitig innerhalb eines SM gestartet werden können (Occupancy). Dies wird als Registerdruck (Register Pressure) bezeichnet. Wenn die Register erschöpft sind, werden die Daten in den langsameren lokalen Speicher (physisch ein Teil des globalen Speichers) ausgelagert, was zu einem katastrophalen Leistungsabfall führt.
3.3 Gemeinsam genutzter Speicher (Shared Memory) und Bankkonflikte
Ein SM verfügt über Shared Memory, einen ultraschnellen On-Chip-Speicher, der vom Programmierer explizit gesteuert werden kann. Er teilt denselben physischen SRAM-Bereich mit dem L1-Cache, fungiert jedoch als expliziter Daten-Cache und wird zur gemeinsamen Nutzung von Daten und zur Synchronisation zwischen Threads innerhalb eines Blocks verwendet.
Die physische Struktur des Shared Memory ist in mehrere unabhängige Module (normalerweise 32) unterteilt, die Speicherbanken (Memory Banks) genannt werden. Aufeinanderfolgende 32-Bit-Adressen werden verschachtelt (interleaved) auf verschiedene Banken verteilt.
Wenn die 32 Threads in einem Warp gleichzeitig auf verschiedene Banken zugreifen, wird der Zugriff vollständig parallel (in 1 Zyklus) verarbeitet. Dies wird als bankkonfliktfrei bezeichnet. Wenn jedoch mehrere Threads gleichzeitig auf verschiedene Adressen in derselben Bank zugreifen wollen, werden die Anforderungen serialisiert und es entsteht eine Strafe (Verzögerung). Dies wird als Bankkonflikt (Bank Conflict) bezeichnet. Bei einem 2-Wege-Bankkonflikt verdoppelt sich beispielsweise die Zugriffszeit, und im schlimmsten Fall, einem 32-Wege-Konflikt, verzögert sie sich um das 32-fache. In Algorithmen wie der Matrixtransposition verursachen Stride-Zugriffe schwerwiegende Bankkonflikte. Daher sind fortgeschrittene Optimierungen mithilfe von Padding (einer Technik zum Einfügen von Dummy-Daten zum Verschieben von Speicheradressen) unerlässlich, um Konflikte zu vermeiden.
Ergänzung zu Kapitel 4: Die Multiply-Accumulate-Pipeline des Tensor-Cores
Die revolutionäre Hardware, die zuerst mit der Volta-Architektur eingeführt wurde und die Leistung von Grafikprozessoren seitdem dramatisch gesteigert hat, ist der Tensor-Core. Die explosive Entwicklung der KI und des Deep Learning wäre ohne Tensor-Cores undenkbar.
4.1 Hardware-Implementierung von Matrix-Multiply-Accumulate (MMA)
Der Großteil der Berechnungen beim Deep Learning besteht aus Matrixmultiplikationen (GEMM: General Matrix Multiply) von Gewichtsmatrizen neuronaler Netze und Eingabedaten. Die Berechnungsformel wird als $D = A \times B + C$ ausgedrückt (wobei $A, B$ Eingabematrizen und $C$ eine Akkumulatormatrix sind).
In herkömmlichen CUDA-Cores wurde dieses Matrixprodukt Element für Element unter Verwendung von FMA-Befehlen (Fused Multiply-Add) berechnet. Im Gegensatz dazu ist der Tensor-Core eine dedizierte Schaltung, die Multiply-Accumulate-Operationen auf kleinen Matrizen (z. B. 4x4 oder 16x16) auf Hardwareebene in einem einzigen Zyklus (oder wenigen Zyklen) ausführt.
Physikalisch werden Dutzende bis Hunderte von Multiplikatoren und ein riesiger Additionsbaum direkt mit Drähten verbunden, wodurch die Multiply-Accumulate-Operation in einem Rutsch abgeschlossen wird, ohne dass Zwischenergebnisse in Register zurückgeschrieben werden müssen. Infolgedessen ist der Berechnungsdurchsatz (TFLOPS) pro Fläche im Vergleich zu normalen CUDA-Cores um Größenordnungen höher.
4.2 Die Geheimnisse der Mixed-Precision
Eine weitere Essenz des Tensor-Cores ist die Unterstützung für Mixed-Precision-Berechnungen. Beim Deep Learning gibt es viele Situationen im Berechnungsprozess, die keine hohe Präzision (FP32/FP64) erfordern. Der Tensor-Core verfügt über eine Pipeline, die die Eingabematrizen $A$ und $B$ mit niedriger Präzision (FP16, BF16 oder sogar noch niedriger FP8, INT8, INT4) einliest, interne Multiplikationen mit niedriger Präzision durchführt und dann den Additions-(Akkumulations-)Prozess mit höherer Präzision (FP32 oder INT32) durchführt.
- FP16 / BF16: Der Standard für das Training. BF16 (Bfloat16) hat denselben 8-Bit-Exponenten wie FP32 und einen weiten Dynamikbereich, wodurch sich das Problem des verschwindenden Gradienten leicht verhindern lässt.
- FP8 / INT8 / INT4: Der Trumpf zur Beschleunigung der Inferenz. Da das Datenübertragungsvolumen (Speicherbandbreite) ebenfalls reduziert wird, verbessert sich der Durchsatz drastisch.
Die Hopper-Architektur führte den “FP8 Tensor Core” ein, der die Berechnungen für Transformer-Modelle dramatisch beschleunigt und theoretisch im Vergleich zu FP32 einen dutzendfach höheren Durchsatz erreicht. Von der Softwareseite (CUDA) wird der Tensor-Core direkt über die wmma (Warp-Level Matrix Multiply and Accumulate) API oder die mma.sync PTX-Anweisung angesteuert. Dabei wird eine extrem komplexe kollektive Verarbeitung durchgeführt, bei der die Threads in einem Warp kooperieren, um Matrixfragmente in Register zu laden, zu berechnen und zu speichern.
Ergänzung zu Kapitel 5: CUDA-Speicherhierarchie und Optimierungstechniken
Egal wie hoch die Rechenleistung eines Grafikprozessors ist, die Leistung wird leiden, wenn die Datenversorgung zum Flaschenhals wird (die “Memory Wall”). Es ist keine Übertreibung zu sagen, dass 90 % der Optimierungen in der CUDA-Programmierung “Speicherzugriffsoptimierungen” sind.
5.1 Coalesced Access zum globalen Speicher
Der globale Speicher, der der Hauptspeicher (HBM oder GDDR) des Grafikprozessors ist, hat eine sehr große Bandbreite (z. B. mehrere TB/s), aber auch eine sehr hohe Latenz von Hunderten von Zyklen.
Das absolute Prinzip zur Maximierung der Zugriffseffizienz auf den globalen Speicher ist Coalescing (Zusammenfassung). Der Speichercontroller des Grafikprozessors greift auf den Speicher in Transaktionseinheiten von 32 Byte, 64 Byte oder 128 Byte zu. Wenn die 32 Threads in einem Warp auf den Speicher zugreifen und ihre Speicheradressen in einen zusammenhängenden Bereich (innerhalb einer ausgerichteten 128-Byte-Grenze) fallen, kombiniert (coalesced) die Hardware diese Anforderungen zu einer einzigen Speichertransaktion zur Verarbeitung.
Wenn Threads stattdessen auf zufällige Adressen zugreifen oder Stride-Zugriffe (mit Abständen) durchführen, findet keine Zusammenfassung statt und es entstehen mehrere Transaktionen. Dies wird als “nicht-koaleszierter Zugriff” bezeichnet und ist ein fataler Performance-Bug, der die effektive Speicherbandbreite auf weniger als ein Zehntel reduzieren kann.
5.2 CUDA C++ Codebeispiel: Matrixtranspositionsoptimierung und Shared Memory
Das Folgende ist ein Beispiel für einen optimierten Kernelcode zur Matrixtransposition, der nicht-koaleszierten Zugriff vermeidet und Shared Memory nutzt, um die Leistung drastisch zu verbessern.
| |
Es gibt 3 Hauptpunkte in diesem Code:
- Coalescing beim Lesen: Das Lesen aus
idataerfolgt in X-Richtung, wothreadIdx.xfortlaufend ist, sodass es vollständig koalesziert wird. - Coalescing beim Schreiben: Auch das Schreiben in
odataist so konzipiert, dass es in derthreadIdx.x-Richtung fortlaufend ist, indem die Blockkoordinaten vertauscht werden, sodass es koalesziert wird. - Padding im Shared Memory: Durch eine Verschiebung (Padding) um ein Element wie in
tile[TILE_DIM][TILE_DIM + 1]werden Bankkonflikte beim Zugriff in Spaltenrichtung (tile[threadIdx.x][threadIdx.y + j]) beim Schreiben vollständig beseitigt.
5.3 Cache-Hierarchie und spezieller Speicher
- L1/L2-Cache-Richtlinien: In neueren Architektur von Grafikprozessoren kann der Programmierer das Verhalten des Caches als Hinweis über PTX-Anweisungen (wie
.ca,.cg,.cs) steuern. Beispielsweise können Daten, auf die nur einmal zugegriffen wird, den L2-Cache umgehen (Streaming Access), um eine Cache-Verschmutzung zu vermeiden. - Texture Memory / Constant Memory: Der für die Bildverarbeitung optimierte Texture Memory nutzt einen speziellen Cache für Zugriffe mit 2D-räumlicher Lokalität. Der Constant Memory bietet eine extrem hohe Effizienz für Broadcast-Zugriffe, bei denen alle Threads dieselbe Konstante lesen.
Ergänzung zu Kapitel 6: Die Zukunft von Grafikprozessoren im Zeitalter des Deep Learning
Die aktuelle Grenze der Computerwissenschaft ist nicht nur die Leistungssteigerung einzelner Grafikprozessoren, sondern die Skalierung des gesamten Systems.
6.1 Ultraschnelle Verbindung mit NVLink und NVSwitch
Riesige LLMs (Large Language Models) passen nicht in den Speicher eines einzelnen Grafikprozessors (z. B. 80 GB oder 144 GB). Um Modellparallelität (Tensor-Parallelität oder Pipeline-Parallelität) durchzuführen, müssen Terabyte an Daten pro Sekunde zwischen den Grafikprozessoren ausgetauscht werden. Da der herkömmliche PCIe-Bus (PCI Express) diese Bandbreite nicht abdecken kann, hat NVIDIA einen proprietären Hochgeschwindigkeits-Interconnect namens NVLink entwickelt. Darüber hinaus ermöglicht ein Switch-Chip namens NVSwitch, dass 8 oder 256 Grafikprozessoren über einen vollständig blockierungsfreien Crossbar-Switch verbunden werden, wodurch ein Cluster aufgebaut wird, der sich wie ein einziger riesiger Grafikprozessor verhält.
6.2 Transformer Engine und das FP8-Ökosystem
Zur Optimierung für die Transformer-Architektur, die zum De-facto-Standard nicht nur in der Verarbeitung natürlicher Sprache, sondern auch in der Bild- und Spracherkennung geworden ist, ist die Hopper-Architektur mit einem Co-Design-Mechanismus aus Hardware und Software namens Transformer Engine ausgestattet. Dieses System überwacht dynamisch Tensor-Statistiken und wechselt die Berechnungspräzision zwischen FP8 und FP16 Schicht für Schicht automatisch (Dynamic Scaling). So wird eine extreme Berechnungsgeschwindigkeit und Einsparung von Speicherbandbreite erzielt, ohne dass es zu einem Genauigkeitsverlust kommt.
6.3 Skalierungsgesetze für Grafikprozessor-Cluster und Zukunftsaussichten
Wie in OpenAIs “Scaling Laws” gezeigt, verbessert sich die Leistung der KI weiter, je mehr Parameter und Rechenleistung das Modell hat. Dementsprechend entwickeln sich Grafikprozessoren von bloßen Prozessoren zu dem Zustand, in dem “das Rechenzentrum selbst ein einziger riesiger Grafikprozessor (Supercomputer)” ist, in dem Zehntausende von Einheiten über Glasfaser verbunden sind.
Die zukünftige Architekturentwicklung wird auf die Einführung von Silizium-Photonik (optische Interconnects), CPO (Co-Packaged Optics) und eine weitere Verfeinerung von 3D-Stapeltechnologien von SRAM bis HBM zusteuern. Doch die unveränderliche DNA der Grafikprozessoren seit ihrer Erfindung – “die Maximierung des Durchsatzes durch Parallelverarbeitung” – wird weiterhin die Speerspitze der Computerwissenschaft bilden.
Fazit: Zum ultimativen Pol der Computerwissenschaft
Die GPU-Architektur ist die komplexeste und auf Durchsatz optimierteste Rechenmaschine, die die Menschheit je geschaffen hat. Wenn die CPU ein “hochleistungsfähiger F1-Rennwagen” ist, kann die GPU mit einem “riesigen Logistiksystem verglichen werden, in dem Zehntausende von Muldenkippern in koordinierten Bewegungen gleichzeitig Material transportieren”.
Die Ausführung von Anweisungen in Warp-Einheiten durch SIMT, das Hardware-Scheduling, das Tausende von Threads in null Zyklen umschaltet, der Coalesced Access, der die Bandbreite bis an die Grenze ausreizt, und die Pipeline der Tensor-Cores, die den Durchbruch beim Deep Learning vorangetrieben haben. All dies ist das Ergebnis der geradezu wahnsinnigen Beharrlichkeit der Ingenieure auf die Frage: “Wie kann man die Gesamtmenge der Fließkommaberechnungen innerhalb der Grenzen physikalischer Gesetze (Lichtgeschwindigkeit, Wärme, Leistung, Grenzen der Siliziumminiaturisierung) maximieren?”.
Für die Software-Ingenieure, KI-Forscher und HPC-Forscher von morgen ist das Verständnis der GPU-Architektur nicht nur Allgemeinbildung. Es ist ein “Pflichtfach”, um intuitiv zu begreifen, was hinter den Frameworks (PyTorch und TensorFlow) passiert, und um die Hardware-Fähigkeiten bis an die Grenzen auszuschöpfen. Bankkonflikte im Speicher vermeiden, Warp-Divergenz beseitigen und die Pipeline der Tensor-Cores weiterhin mit Daten füllen. Am Ende dieser Optimierungen ist die Zukunft, in der Berechnungen, die früher auf Supercomputern Monate dauerten, heute auf ein paar GPUs auf dem Schreibtisch in wenigen Stunden abgeschlossen sind, bereits Realität geworden.
Wir leben jetzt im goldenen Zeitalter der aufregendsten Computerarchitektur der Menschheitsgeschichte. Es könnten genau Sie, der diese Zeilen liest, sein, der die Physik von CUDA und die Essenz der massiv parallelen Architektur von GPUs versteht und die Innovationen der nächsten Generation hervorbringt.
Glossar (Fachbegriffe)
- SM (Streaming Multiprocessor): Der Hauptberechnungsblock einer GPU. Entspricht einem Kern in einer CPU, enthält aber intern zahlreiche CUDA-Cores, Warp-Scheduler, Shared Memory etc.
- SIMT (Single Instruction, Multiple Threads): Ein GPU-spezifisches Ausführungsmodell, bei dem alle Threads in einem Warp dieselbe Anweisung teilen und dabei Berechnungen auf unabhängigen Daten durchführen.
- Warp: Eine Ansammlung von 32 Threads. Die kleinste Einheit für Hardware-Scheduling und Befehlsausgabe.
- Warp Divergence (Warp-Divergenz): Ein Phänomen, bei dem sich Verzweigungsbedingungen unter den Threads in einem Warp unterscheiden und die Ausführungspfade serialisiert werden, was den Durchsatz verringert.
- Tensor Core (Tensor-Kern): Eine spezielle Schaltung, die Matrix-Multiply-Accumulate (MMA) Operationen auf Hardwareebene in einem Rutsch verarbeitet. Speziell zur Beschleunigung von Deep Learning.
- Coalesced Access (Koaleszierter Zugriff): Ein Mechanismus, bei dem die Hardware Speicherzugriffe auf aufeinanderfolgende Adressen von Threads in einem Warp zu einer einzigen Transaktion zusammenfasst, um eine hohe Bandbreite zu erreichen.
- Shared Memory (Gemeinsamer Speicher): Ein ultraschneller L1-Scratchpad-Speicher, der vom Programmierer gesteuert werden kann und im SM integriert ist.
- Bank Conflict (Bankkonflikt): Eine Strafe, die auftritt, wenn mehrere Threads im Shared Memory gleichzeitig auf verschiedene Adressen in derselben Speicherbank zugreifen, was zu einer Serialisierung der Zugriffe führt.
- Occupancy (Auslastung): Das Verhältnis der tatsächlichen zur theoretisch maximalen Anzahl von Warps, die gleichzeitig auf einem SM aktiv sein können. Je höher, desto leichter lassen sich Speicherzugriffslatenzen verbergen.
- Register Spilling (Registerauslagerung): Ein Phänomen, bei dem die Anzahl der von einem Thread verwendeten Register das Hardware-Limit überschreitet und die überschüssigen Daten in einen langsameren Speicher (lokalen Speicher) ausgelagert werden.
Referenzen und empfohlene Leseliste
- NVIDIA CUDA C++ Programming Guide: Die offizielle Dokumentation, die jeder CUDA-Programmierer lesen sollte. Deckt Speicherzugriffsmuster und Best Practices zur Optimierung umfassend ab.
- NVIDIA Ampere / Hopper Architecture Whitepaper: Offizielle Whitepapers mit Details zur Tensor-Core-Pipeline, asynchronen Speicherübertragungen und der Hardware-Implementierung der Transformer Engine.
- Computer Architecture: A Quantitative Approach (John L. Hennessy, David A. Patterson): Ein klassisches Meisterwerk zur Computerarchitektur. Bietet tiefe Einblicke in die Unterschiede in der Designphilosophie von CPUs und GPUs, die Cache-Hierarchie und Parallelität auf Befehlsebene.
- Programming Massively Parallel Processors: A Hands-on Approach (David B. Kirk, Wen-mei W. Hwu): Ein Lehrbuch, das die CUDA-Programmierung aus der Perspektive des Algorithmus-Designs erklärt. Behandelt detailliert Implementierungen von Tiling-Techniken im Shared Memory, Reduktion und Präfix-Summen.
- Dissecting the NVIDIA Volta GPU Architecture via Microbenchmarking: Ein akademisches Papier. Ein Meisterwerk, das mithilfe von Micro-Benchmarks die genauen Latenzen von Caches und den Durchsatz von Tensor-Cores aufdeckt, die NVIDIA nicht veröffentlicht hat.
Das in diesem Artikel erläuterte Architekturwissen kann teilweise mit der Weiterentwicklung der Hardware obsolet werden, aber die grundlegenden physikalischen Prinzipien – “Bandbreite maximieren, Parallelität nutzen und Latenz verbergen” – werden als universelle Wahrheiten der Computerwissenschaft erhalten bleiben.