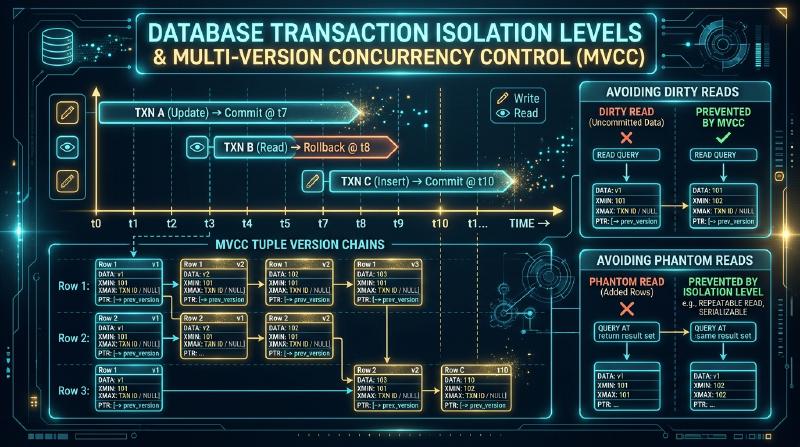
Datenbank-Transaktionsisolationsstufen und MVCC: Die Realität von ACID und Multi-Version Concurrency Control
In modernen Softwarearchitekturen bleiben relationale Datenbankmanagementsysteme (RDBMS) weiterhin der Grundpfeiler der Datenpersistenz. Den Kern davon bildet das Konzept der „Transaktion“, und insbesondere die ACID-Eigenschaften (Atomicity, Consistency, Isolation, Durability) sind weithin als Basistheorie für den Aufbau robuster Systeme anerkannt. Doch unter den ACID-Eigenschaften ist die „Isolation“ (Isolationsfähigkeit) der Bereich, in dem die größte Diskrepanz zwischen Theorie und Praxis besteht.
In diesem Artikel werden wir von den historischen Hintergründen der Transaktionsisolationsstufen von Datenbanken über die Grenzen des ANSI SQL-92-Standards bis hin zur internen Struktur von Multi-Version Concurrency Control (MVCC), die von modernen Datenbank-Engines verwendet wird, aus einer äußerst detaillierten, akademischen und praktischen Perspektive tief eintauchen. Insbesondere werden wir die entscheidenden Unterschiede in der MVCC-Implementierung der beiden großen Open-Source-RDBMS, PostgreSQL und MySQL (InnoDB), analysieren und bis hin zur Serializable Snapshot Isolation (SSI), der vordersten Front verteilter Datenbanken, alles abdecken und Ihnen dieses Meisterwerk mit insgesamt über 12.000 Zeichen präsentieren.
Kapitel 1: Der Mythos der ACID-Eigenschaften und das Dilemma der Nebenläufigkeit
1.1 Das Ideal der Serialisierbarkeit (Serializability)
Das ultimative Ideal, das die Isolation einer Transaktion anstrebt, ist die „Serialisierbarkeit“ (Serializability). Dies bezeichnet die Eigenschaft, dass selbst wenn mehrere Transaktionen gleichzeitig und parallel ausgeführt werden, das Ausführungsergebnis „dem Ergebnis entspricht, als ob die Transaktionen nacheinander seriell (in Reihe) in irgendeiner Reihenfolge ausgeführt worden wären“.
Wenn die Transaktionen $T_1$ und $T_2$ gleichzeitig auf dem System ausgeführt werden, unabhängig davon, wie das Interleaving (Verschränkung der Operationen) durch die parallele Ausführung auftritt, gilt der Zeitplan als serialisierbar, wenn der endgültige Datenbankzustand vollständig mit dem Ergebnis übereinstimmt, das durch die Ausführung in der Reihenfolge „$T_1 \rightarrow T_2$“ oder „$T_2 \rightarrow T_1$“ erzielt worden wäre. Wenn diese Serialisierbarkeit garantiert ist, können sich Anwendungsentwickler ausschließlich auf den Aufbau der Geschäftslogik konzentrieren, ohne sich überhaupt um Dateninkonsistenzen durch Nebenläufigkeit (wie Race Conditions oder unsachgemäßes Überschreiben) kümmern zu müssen.
1.2 Leistungseinbruch durch Serialisierung mittels Sperren
In frühen Datenbanksystemen wurde ein strenger Sperrmechanismus namens „Two-Phase Locking“ (2PL) eingesetzt, um diese Serialisierbarkeit zu gewährleisten. Bei 2PL muss eine Transaktion vor dem Lesen oder Schreiben von Daten immer eine Sperre (Shared Lock oder Exclusive Lock) erwerben (Phase 1: Growing Phase) und alle Sperren am Ende der Transaktion (beim Commit oder Rollback) wieder freigeben (Phase 2: Shrinking Phase).
Dieser strenge Sperrmechanismus hatte jedoch einen fatalen Fehler. Es war eine „extreme Leistungsverschlechterung“.
- Leseoperationen blockieren Schreiboperationen.
- Schreiboperationen blockieren Leseoperationen.
- Erhöhte Wartezeiten aufgrund von Sperrkonflikten und häufige Deadlocks.
Als der Datenverkehr zunahm und viele Benutzer gleichzeitig auf die Datenbank zugriffen, wurde die vollständige Serialisierung durch 2PL zu einem Systemengpass, und der Durchsatz sank drastisch. Das System stand vor einem Trade-off-Dilemma zwischen „Datenkonsistenz“ und „Nebenläufigkeitsleistung“ (Durchsatz).
1.3 Die Geschichte und Kompromisse der Concurrency Control (Nebenläufigkeitskontrolle)
Um dieses Dilemma zu lösen, Datenbankingenieure und Forscher das Konzept der „Isolationsstufe“ (Isolation Level) ein. Dies ist ein „Produkt des Kompromisses“, das die vollständige Serialisierbarkeit teilweise lockert und das Auftreten bestimmter Dateninkonsistenzen (Anomalien) zulässt, um im Gegenzug die Leistung der Nebenläufigkeit zu verbessern. Dadurch wurde es möglich, je nach Anwendungsanforderungen das Gleichgewicht zwischen Konsistenz und Leistung zu wählen.
Kapitel 2: Der ANSI SQL-92 Standard für Isolationsstufen und seine Kritik
2.1 Definition der Isolationsstufen durch den ANSI SQL-92 Standard
Der 1992 verabschiedete SQL-Standard „SQL-92“ definierte vier Isolationsstufen basierend auf drei typischen Anomalien (Phenomena), die durch Nebenläufigkeit auftreten können.
Die drei definierten Anomalien (Phenomena)
- Dirty Read (Schmutziges Lesen): Das Phänomen, bei dem Transaktion $T_1$ Daten aktualisiert und sich noch im un-committeten Zustand befindet, während eine andere Transaktion $T_2$ diese un-committeten Daten liest. Wenn $T_1$ ein Rollback durchführt, hat $T_2$ Phantom-Daten gelesen, die gar nicht existieren.
- Non-repeatable Read (Nicht-wiederholbares Lesen): Das Phänomen, bei dem Transaktion $T_1$ dieselbe Zeile zweimal liest und in der Zwischenzeit eine andere Transaktion $T_2$ diese Zeile aktualisiert und committet. Das Ergebnis des ersten und zweiten Lesevorgangs von $T_1$ unterscheidet sich.
- Phantom Read (Phantom-Lesen): Das Phänomen, bei dem Transaktion $T_1$ mehrere Zeilen unter einer bestimmten Suchbedingung liest und in der Zwischenzeit eine andere Transaktion $T_2$ eine neue Zeile, die dieser Bedingung entspricht, einfügt (oder löscht) und committet. Wenn $T_1$ mit derselben Bedingung erneut sucht, ändert sich die Anzahl der Zeilen.
Die vier Isolationsstufen nach SQL-92
SQL-92 definierte Isolationsstufen danach, wie gut sie das Auftreten dieser Anomalien verhindern.
- Read Uncommitted: Lässt Dirty Read zu.
- Read Committed: Verhindert Dirty Read, lässt aber Non-repeatable Read und Phantom Read zu.
- Repeatable Read: Verhindert Dirty Read und Non-repeatable Read, lässt aber Phantom Read zu.
- Serializable: Verhindert alle Anomalien und garantiert vollständige Serialisierbarkeit.
2.2 Die Kritik von Berenson et al.: “A Critique of ANSI SQL Isolation Levels”
Auf den ersten Blick erscheint die Definition des SQL-92-Standards sehr klar und logisch. Jedoch veröffentlichten 1995 die Datenbankgiganten Hal Berenson, Jim Gray (Turing-Preisträger), Phil Bernstein und andere ein Paper mit dem Titel „A Critique of ANSI SQL Isolation Levels“, das dieser ANSI-Standarddefinition einen verheerenden Schlag versetzte.
Die in diesem Paper aufgezeigten Hauptmängel des SQL-92-Standards sind folgende:
1. Die implizite Annahme von Sperren
Die Definition von SQL-92 ging implizit davon aus, dass „die Datenbank mit einer Lock-basierten Concurrency Control (2PL) implementiert ist“. In den 1990er Jahren begannen jedoch bereits Datenbanken aufzutauchen, die MVCC (siehe unten) und andere Optimistic Concurrency Controls (OCC) verwendeten, wodurch eine auf Sperren basierende Definition von Anomalien veraltet war.
2. Unklarheit und Unvollständigkeit der Definition
Es wurde darauf hingewiesen, dass die drei in SQL-92 definierten Anomalien (Dirty Read, Non-repeatable Read, Phantom Read) nicht alle Anomalien abdecken, die bei Nebenläufigkeit auftreten können. Zum Beispiel gibt es das Phänomen des „Dirty Write“. Dies ist ein Phänomen, bei dem Daten, die von einer nicht committeten Transaktion geschrieben wurden, von einer anderen nicht committeten Transaktion überschrieben werden. Der SQL-92-Standard erwähnt Dirty Write jedoch nicht. Obwohl alle Isolationsstufen (einschließlich Read Uncommitted) Dirty Write verhindern müssen (sonst bricht die interne Konsistenz der Datenbank zusammen), ging der Standard nicht darauf ein.
3. Entdeckung neuer Anomalien
In dem Paper wurden mehrere neue Anomalien definiert, die im SQL-92-Standard nicht existieren. Die beiden bekanntesten sind:
- Lost Update (Verlorenes Update): Das Phänomen, bei dem zwei Transaktionen gleichzeitig dieselben Daten lesen und beim Zurückschreiben ihrer Berechnungsergebnisse das Update der einen das Update der anderen überschreibt und somit auslöscht.
- Write Skew (Schreib-Skew): Ein spezifisches Phänomen der Snapshot-Isolation, das später erklärt wird.
Das Paper von Berenson et al. bewies, dass der SQL-92-Standard die Isolationsstufen mathematisch und strikt nicht definieren konnte, und versetzte der Datenbankbranche einen massiven Schock. In der heutigen Datenbanktheorie wird die Definition der Isolationsstufen nach ANSI SQL-92 als „etwas, das als historischer Hintergrund gelernt werden sollte“ und „als strikte technische Definition unzureichend“ behandelt.
Kapitel 3: Snapshot-Isolation (Snapshot Isolation) und Write Skew
3.1 Der Unterschied zwischen Repeatable Read und Snapshot-Isolation
Besondere Aufmerksamkeit im Paper von Berenson et al. erhielt der Vorschlag einer neuen Isolationsstufe namens „Snapshot-Isolation (SI)“.
In vielen Datenbanken, die MVCC verwenden (wie PostgreSQL und Oracle), ist die als „Repeatable Read“ angebotene Isolationsstufe in Wirklichkeit diese „Snapshot-Isolation“. Bei der Snapshot-Isolation liest jede Transaktion aus einem konsistenten „Snapshot (einem statischen Zustand aus der Vergangenheit)“ der Datenbank zum Zeitpunkt des Transaktionsstarts.
- Aktualisierungen durch andere Transaktionen, die nach Beginn der Transaktion vorgenommen wurden, sind überhaupt nicht sichtbar (Verhinderung von Non-repeatable Read).
- Da die bloße Existenz der Datensätze in der Vergangenheit fixiert ist, sind auch INSERTs durch andere Transaktionen nicht sichtbar (Verhinderung von Phantom Read).
Mit anderen Worten, die Snapshot-Isolation erfüllt nicht nur die Anforderungen von „Repeatable Read“ nach SQL-92, sondern verhindert in vielen Fällen sogar „Phantom Read“. Ist Snapshot-Isolation also gleichbedeutend mit „Serializable“? Die Antwort ist „Nein“. Denn bei der Snapshot-Isolation gibt es eine fatale Anomalie namens „Write Skew“, die nicht serialisierbar ist.
3.2 Das Arzt-Bereitschaftsproblem und Write Skew
Das bekannteste Beispiel zum Verständnis von Write Skew ist das „Arzt-Bereitschaftssystem“.
[Geschäftsregel] Angenommen, es gibt ein Schichtverwaltungssystem in einem Krankenhaus mit der Regel: „Mindestens ein Arzt muss sich immer im Bereitschaftsdienst (On-Call) befinden.“
Derzeit befinden sich zwei Ärzte, Alice und Bob, im Bereitschaftsdienst (on_call = true).
Zu diesem Zeitpunkt denken Alice und Bob zufällig gleichzeitig: „Mir geht es nicht gut, ich möchte aus dem Bereitschaftsdienst genommen werden“, und starten von ihren jeweiligen Terminals aus Transaktionen zur Schichtänderung.
[Transaktionsablauf (unter Snapshot-Isolation)]
- [Tx1: Alice] Bezieht einen Snapshot. Bestätigt, dass derzeit zwei Personen, Alice und Bob, auf Bereitschaft sind.
SELECT count(*) FROM doctors WHERE on_call = true;-> Ergebnis: 2 - [Tx2: Bob] Bezieht einen Snapshot. Bestätigt ebenfalls, dass es zwei Personen sind, Alice und Bob.
SELECT count(*) FROM doctors WHERE on_call = true;-> Ergebnis: 2 - [Tx1: Alice] Urteilt, dass die Regel (1 oder mehr Personen auf Bereitschaft) erfüllt ist, und entfernt sich selbst aus dem Bereitschaftsdienst.
UPDATE doctors SET on_call = false WHERE name = 'Alice'; - [Tx2: Bob] Urteilt ebenfalls, dass die Regel erfüllt ist, und entfernt sich selbst aus dem Bereitschaftsdienst.
UPDATE doctors SET on_call = false WHERE name = 'Bob'; - [Tx1: Alice] Commit erfolgreich.
- [Tx2: Bob] Commit erfolgreich. (Da Alice und Bob verschiedene Datensätze aktualisieren, kommt es nicht zu Konflikten bei den Zeilensperren.)
[Ergebnis] Als Ergebnis des Commits beider Tx1 und Tx2 liegt die Anzahl der Ärzte auf Bereitschaft bei „0“. Die Geschäftsregel ist zusammengebrochen.
Das ist Write Skew. Wenn es serialisierbar (Serializable) wäre, würde entweder Tx1 oder Tx2 zuerst seriell ausgeführt werden, so dass die später ausgeführte Transaktion erkennen würde, dass die Anzahl der Personen auf Bereitschaft „1“ beträgt, und ihre eigene Entfernung abbrechen (Rollback) könnte. Bei der Snapshot-Isolation wird die Kollision jedoch nicht erkannt, da sie voneinander abweichende Datenzeilen (Alice-Zeile und Bob-Zeile) aktualisieren, was zu Inkonsistenzen in den Geschäftsregeln führt.
3.3 ReadOnly Anomaly (Nur-Lese-Anomalie)
Darüber hinaus gibt es bei der Snapshot-Isolation eine äußerst spezielle Anomalie namens ReadOnly Anomaly, bei der die Serialisierbarkeit durch das Eingreifen einer „Nur-Lese-Transaktion“ gebrochen wird. Diese Anomalie, die häufig am Beispiel von Bankkontoständen und Zinsgutschriften gezeigt wird, ist ein Phänomen, bei dem eine Nur-Lese-Transaktion, obwohl es keinen Konflikt zwischen den Aktualisierungstransaktionen gibt, durch Betrachtung eines vergangenen Snapshots einen „logisch unmöglichen Zustand auf der Zeitachse“ liest. Aufgrund der Existenz dieser Anomalien wird die Snapshot-Isolation vom Serialisierbaren im strikten Sinne unterschieden.
Kapitel 4: Das Funktionsprinzip von MVCC (Multi-Version Concurrency Control)
Bisher haben wir die Theorie der Isolationsstufen und deren Anomalien diskutiert, aber wie kontrollieren moderne Datenbanken diese? Die Kerntechnologie dafür ist MVCC (Multi-Version Concurrency Control).
4.1 „Lesen blockiert nicht das Schreiben, und Schreiben blockiert nicht das Lesen“
Das wichtigste Designkonzept von MVCC und der entscheidende Unterschied zur sperrenbasierten Kontrolle (2PL) liegt darin, dass „Lesen und Schreiben einander nicht blockieren“. Wenn ein Datensatz aktualisiert wird, überschreibt die MVCC-Datenbank den bestehenden Datensatz nicht direkt (In-Place Update). Stattdessen erstellt sie eine neue Version des Datensatzes (Version/Tupel) und behält gleichzeitig die alte Version des Datensatzes.
Dadurch existieren mehrere Versionen (ein Verlauf von der Vergangenheit bis zur Gegenwart) desselben Datensatzes gleichzeitig in der Datenbank. Wenn eine Transaktion Daten liest, berechnet und liest sie basierend auf ihrer eigenen „Transaktions-ID (XID)“ oder „Startzeit (Zeitstempel)“ die „korrekte vergangene Version, die sie lesen sollte“, aus den vielen im System vorhandenen Versionen.
Dies ermöglicht es anderen Transaktionen, die „vergangene Version vor der Änderung“ zu lesen, selbst wenn eine Transaktion gerade einen Datensatz überschreibt, wodurch Wartezeiten durch Sperren vermieden werden.
4.2 Versionsverwaltungskette von Tupeln und Sichtbarkeitsregeln (Visibility)
Der wichtigste Algorithmus in MVCC ist die Sichtbarkeitsregel (Visibility Rule), die bestimmt, „welche Transaktion welche Version der Daten sehen kann“.
Jeder Transaktion wird bei ihrem Start eine eindeutige, monoton steigende Transaktions-ID (XID) zugewiesen. Jeder in der Datenbank gespeicherten Datensatzversion (Tupel) werden folgende Informationen als Metadaten beigefügt:
- Erstellungs-XID: Die ID der Transaktion, die diese Version durch INSERT/UPDATE erstellt hat.
- Lösch-XID: Die ID der Transaktion, die diese Version durch UPDATE/DELETE logisch gelöscht (invalidiert) hat.
Wenn Transaktion $T_i$ eine Datenzeile liest, beurteilt sie die Sichtbarkeit anhand der folgenden Grundregeln:
- Ist sie committet?: Wurde die Transaktion der Erstellungs-XID bereits committet?
- Ist sie nicht in der Zukunft?: Ist die Erstellungs-XID eine Transaktion, die zeitlich vor dem Start von $T_i$ lag?
- Wurde sie nicht gelöscht?: Ist die Lösch-XID nicht gesetzt, oder wurde die Transaktion der Lösch-XID noch nicht committet, oder ist sie eine Transaktion in der Zukunft ab dem Startzeitpunkt von $T_i$?
Durch die strikte Evaluierung dieser Bedingungen wird jeder Transaktion ein konsistenter Snapshot zur Verfügung gestellt.
Kapitel 5: Der entscheidende Unterschied zwischen den MVCC-Implementierungen von PostgreSQL und MySQL (InnoDB)
Obwohl die Grundphilosophie von MVCC dieselbe ist, unterscheidet sich die interne Implementierung je nach Datenbankprodukt erstaunlich stark. Hier werden wir die MVCC-Architekturen von PostgreSQL und MySQL (InnoDB), den beiden Giganten der Open-Source-Welt, vergleichend analysieren.
5.1 Die MVCC-Implementierung von PostgreSQL: Append-only im Heap und die Notwendigkeit von VACUUM
PostgreSQLs MVCC verwendet eine sehr einzigartige und intuitive „Append-only (Nur-Anhängen) Architektur“.
5.1.1 Bit-Beurteilungslogik durch xmin und xmax
In der Datendatei (Heap), die das eigentliche Wesen einer PostgreSQL-Tabelle darstellt, werden im Header jeder Zeile (Tupel) zwei Transaktions-IDs, xmin und xmax, aufgezeichnet.
xmin(Transaction ID of Insert): Die XID der Transaktion, die dieses Tupel erstellt hat.xmax(Transaction ID of Delete): Die XID der Transaktion, die dieses Tupel gelöscht hat (oder logisches Löschen der alten Version durch ein Update).
[Verhalten der UPDATE-Operation]
In PostgreSQL wird ein UPDATE logischerweise als Kombination aus DELETE und INSERT verarbeitet.
- Schreibe die aktuelle Transaktions-XID in das
xmaxdes alten Tupels. (Logisches Löschen) - Erstelle ein völlig neues Tupel im freien Bereich des Heaps, schreibe die neuen Daten und setze
xminauf die aktuelle Transaktions-XID. (Neues Hinzufügen)
Mit anderen Worten, sowohl die alten als auch die neuen Tupel werden gemischt in derselben Tabellendatendatei (Heap) gespeichert.
5.1.2 Riesige Vorteile und fatale Herausforderungen: Die Existenz von VACUUM
Der größte Vorteil dieser Architektur besteht darin, dass Rollbacks extrem schnell sind. Wenn eine Transaktion abgebrochen (abort) wird, muss das hinzugefügte Tupel nur als „nicht committet“ behandelt werden, und es ist kein Zurückschreiben der Daten erforderlich.
Die fatale Herausforderung ist jedoch das „Aufblähen durch nicht mehr benötigte Tupel (Dead Tuples)“.
Wenn UPDATEs und DELETEs wiederholt werden, sammeln sich alte Versionen von Tupeln, auf die von niemandem mehr verwiesen wird (Tupel, deren xmax zu einer alten, bereits committeten Transaktions-ID geworden ist), unendlich oft im Heap an. Wenn dies unbeaufsichtigt bleibt, explodiert die physische Größe der Tabelle und die Leistung des Sequential Scans wird katastrophal abnehmen.
Der Systemprozess zum physischen Löschen dieser nicht mehr benötigten Tupel und zur Wiederverwendbarkeit des freien Speicherplatzes ist VACUUM (sowie der automatisch ausgeführte autovacuum-Daemon). Der Grund, warum das Tuning von VACUUM beim Betrieb von PostgreSQL als extrem wichtig erachtet wird, liegt in der Wurzel dieser MVCC-Architektur.
5.2 Die MVCC-Implementierung von MySQL InnoDB: In-Place Update und dynamische Rekonstruktion des Undo-Logs
Andererseits verwendet InnoDB, die Standard-Speicher-Engine von MySQL, eine Architektur, die eher Oracle Database ähnelt, mit „In-Place Update und Undo-Logs (Rollback-Segmente)“.
5.2.1 Clustered Index und In-Place Update
Die Tabellen von InnoDB sind als B+Tree (Clustered Index) aufgebaut, der auf dem Primärschlüssel basiert.
Wenn ein UPDATE in InnoDB ausgeführt wird, werden neue Zeilen nicht wie in PostgreSQL angehängt, sondern die Datenzeile auf dem B+Tree wird direkt überschrieben (In-Place Update).
Was ist dann zu tun, wenn eine andere Transaktion einen vergangenen Snapshot lesen möchte? Zu diesem Zweck verschiebt InnoDB die „alten Daten“ vor dem Überschreiben in einen dedizierten Bereich, das Undo-Log (Undo Log Segment).
5.2.2 Vergangene dynamische Rekonstruktion durch Roll-Pointer (Roll Pointer)
Die versteckten Spalten jeder Datenzeile in InnoDB enthalten die folgenden zwei:
DB_TRX_ID: Die ID der Transaktion, die diese Zeile zuletzt eingefügt oder aktualisiert hat.DB_ROLL_PTR(Roll Pointer): Ein Zeiger, der auf den Ort im Undo-Log verweist, an dem die „nächstältere Version“ dieser Zeile gespeichert ist.
Der Prozess für eine Transaktion zum Lesen eines vergangenen Snapshots ist wie folgt:
- Lies die neueste Datenzeile aus dem B+Tree.
- Überprüfe
DB_TRX_IDund wenn es sich um ein Update einer Transaktion in der Zukunft bezogen auf den eigenen Snapshot handelt, urteile, dass diese neueste Zeile nicht gelesen werden darf. - Folge dem
DB_ROLL_PTRund hole die Daten der vergangenen Version aus dem Undo-Log. - Verwende die Daten aus dem Undo-Log, um den Zustand des vergangenen Datensatzes im Speicher dynamisch zu rekonstruieren (Rollback in memory).
- Wenn es sich immer noch um ein Update aus der Zukunft handelt, gehe die Undo-Log-Kette weiter in die Vergangenheit zurück.
5.2.3 Vorteile und Herausforderungen von InnoDB
Der Vorteil dieser Architektur ist, dass sich der Haupttabellenbereich (Tablespace) kaum aufbläht. Die neuesten Daten befinden sich immer an der richtigen Position im B+Tree und vergangene Versionen sind in einem separaten Bereich (Undo-Log) isoliert, wodurch eine hohe physische Scan-Effizienz aufrechterhalten wird (ein groß angelegtes VACUUM wie bei PostgreSQL ist nicht erforderlich, und der Purge-Prozess des Undo-Logs läuft leicht im Hintergrund).
Der Nachteil ist jedoch, dass bei langlaufenden Transaktionen (wie Batch-Verarbeitungen oder mysqldump), die viele vergangene Snapshots lesen, ein Overhead entsteht, um Daten durch tiefes Zurückgehen im Undo-Log zu rekonstruieren, was die Leseleistung verringert. Darüber hinaus birgt es das Risiko, dass sich das Undo-Log selbst aufbläht und Speicherplatz beansprucht.
Kapitel 6: Serializable Snapshot Isolation (SSI) und die vorderste Front der verteilten Datenbanken
Die Evolution von MVCC endet hier nicht. Wie im Kapitel 3 erläutert, wies die Snapshot-Isolation (SI) Anomalien wie „Write Skew“ auf und war nicht vollständig Serializable. Um Anwendungsentwicklern jedoch die Komplexität der Nebenläufigkeit zu ersparen, musste die vollständige Serialisierbarkeit (Serializable) erreicht werden, während die hohe Leistung von MVCC beibehalten wird.
6.1 Die Geburt der Serializable Snapshot Isolation (SSI)
Im Jahr 2008 wurde in einem Paper von Michael Cahill und anderen ein bahnbrechender Algorithmus namens „Serializable Snapshot Isolation (SSI)“ veröffentlicht. Dies ist eine Technologie, die eine vollständige Serialisierbarkeit (Serializable) garantiert und dabei auf einer MVCC-Architektur basiert. PostgreSQL adoptierte dieses SSI ab Version 9.1 schnell als Implementierung für die Isolationsstufe „Serializable“.
Funktionsprinzip von SSI: Konfliktgraph und gefährliche Strukturen (rw-antidependency)
SSI führt keine Blockierung durch Sperren durch. Stattdessen wird während der Ausführung der Transaktion feingranular verfolgt, „welche Daten gelesen (Read) und welche Daten geschrieben (Write) wurden“.
SSI überwacht die Konfliktbeziehungen zwischen Transaktionen und sucht nach bestimmten Konfliktmustern namens „rw-antidependency (Read-Write-Antidependenz)“. Konkret handelt es sich um eine Beziehung, bei der Transaktion $T_1$ Daten einer vergangenen Version liest und diese Daten später von einer anderen Transaktion $T_2$ überschrieben und committet werden. SSI baut intern einen Konfliktgraphen von Transaktionen auf, und in dem Moment, in dem es eine „Struktur, in der zwei Pfeile der rw-antidependency aufeinander folgen (gefährliche Struktur)“ erkennt, urteilt es, dass die Möglichkeit besteht, dass die Serialisierbarkeit zusammenbricht, und erzwingt einen Abbruch (Rollback) der einen Transaktion.
Dadurch stoppt es Transaktionen, bevor Anomalien wie Write Skew (z. B. das Arzt-Bereitschaftsproblem) auftreten, und garantiert im Ergebnis ein vollständiges Serializable. Man kann es als die ultimative Form der Optimistic Concurrency Control (OCC) bezeichnen.
6.2 MVCC in verteilten Datenbanken: Spanner, CockroachDB, TiDB
Moderne Datenbanktechnologie überschreitet die Grenzen einzelner Server und entwickelt sich hin zu verteilten SQL-Datenbanken (NewSQL), die auf Rechenzentren weltweit verteilt sind. In einer verteilten Umgebung war die Realisierung eines MVCC mit globaler Konsistenz auch eine Herausforderung an die Gesetze der Physik.
Google Spanner und TrueTime API
Googles Spanner entwickelte die TrueTime API, um das Problem der Anordnung von Transaktionen in verteilten Systemen zu lösen. Unter der Prämisse, dass die Uhren (physischen Uhren) jedes Servers zwangsläufig abweichen (Clock Skew), kombiniert es GPS und Atomuhren, um die aktuelle Zeit als „Unsicherheitsbereich (Time Window)“ bereitzustellen. Das MVCC von Spanner wartet, bis dieses TrueTime-Unsicherheitsfenster beim Commit einer Transaktion verstrichen ist (Commit Wait), wodurch physisch garantiert wird, dass „Transaktionen mit kausalen Beziehungen immer die richtige Reihenfolge der Zeitstempel haben (External Consistency / externe Konsistenz)“.
CockroachDB und HLC (Hybrid Logical Clock)
CockroachDB, eine von Spanner inspirierte Open-Source-Datenbank, verwendet HLC (Hybrid Logical Clock), um eine ähnliche Konsistenz ohne teure Atomuhren zu erreichen. Durch die Kombination der Synchronisierung physischer Uhren durch NTP und der logischen Lamport-Uhr (einem Zähler basierend auf kausalen Beziehungen zwischen Ereignissen) generiert es global konsistente MVCC-Snapshot-Zeitstempel zwischen verteilten Knoten und realisiert SSI (Serializable Snapshot Isolation) in einer verteilten Umgebung.
TiDB und das Percolator-Modell
TiDB, entwickelt von PingCAP, verwendet ein Modell verteilter Transaktionen basierend auf dem Google Percolator-Modell. Es ist eine Architektur, bei der eine einzige Komponente (Placement Driver: PD) vorbereitet ist, um globale Zeitstempel auszugeben, und die Speicher-Engine (TiKV) jedes Knotens verwendet diesen Zeitstempel, um MVCC lokal zu verarbeiten. Während es auf 2PC (Two-Phase Commit) basiert, minimiert es die Sperrhaltezeit und balanciert riesige Transaktionen und MVCC in einer verteilten Umgebung aus.
Fazit: Über ACID hinaus
Die Transaktionsisolationsstufe einer Datenbank ist keineswegs nur ein Auswendiglern-Thema. Sie ist die Geschichte eines jahrzehntelangen Kampfes in der Informatik darüber, wie man die widersprüchlichen Anforderungen von Datenkonsistenz und Systemleistung miteinander in Einklang bringen kann.
Beginnend mit der unvollständigen Definition von ANSI SQL-92, über die dramatische Verbesserung der Nebenläufigkeit durch MVCC, die Verzweigung der Architekturen von PostgreSQL und InnoDB, bis hin zur Herausforderung der ultimativen Konsistenz durch SSI und verteilte Datenbanken. Ein tiefes Verständnis dieser internen Strukturen wird sicherlich eine mächtige Waffe beim Entwerfen robusterer und leistungsstärkerer Anwendungen sein.
Wir leben heute in einer Zeit, in der die ACID-Eigenschaften kein reiner „Mythos“ mehr sind, sondern durch fortschrittliche Algorithmen und physische Uhrensynchronisation als „Realität“ implementiert werden. Für einen Ingenieur, der den Ozean der Daten navigiert, ist das Kennenlernen der Abgründe von Datenbank-Engines eine intellektuelle Entdeckungsreise, die niemals enden wird.