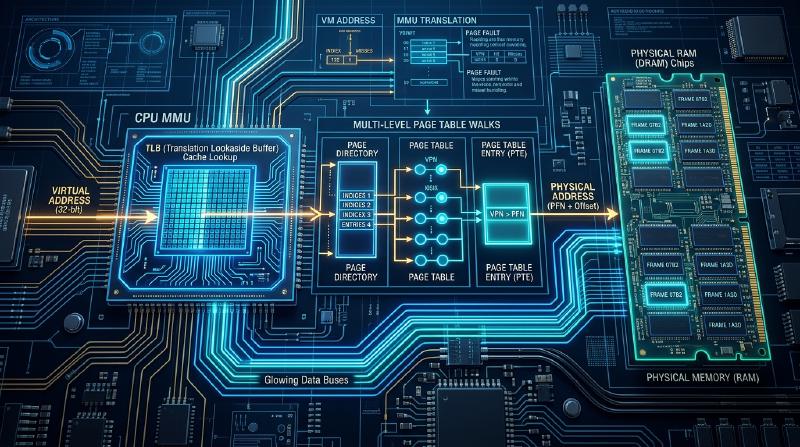
تشريح كامل للذاكرة الافتراضية وآلية ترقيم الصفحات: من وحدة إدارة الذاكرة (MMU) إلى TLB، وHugePage، وأعماق إدارة الذاكرة
في أنظمة التشغيل (OS) الحديثة وبنية وحدات المعالجة المركزية (CPU)، تعد “الذاكرة الافتراضية (Virtual Memory)” و"ترقيم الصفحات (Paging)" من أكثر الأنظمة تعقيدًا ولكنها الأهم. خلف مساحة الذاكرة التي لا يدركها مطورو التطبيقات عادةً، تعمل وحدة إدارة الذاكرة (MMU) الخاصة بالأجهزة ونواة نظام التشغيل معًا بشكل وثيق لإجراء تحويلات هائلة للعناوين ومعالجة الاستثناءات في عالم النانو ثانية.
في هذه المقالة، سنشرح بالتفصيل أعمق أجزاء نظام الذاكرة الافتراضية من منظور البنية الداخلية لنظام التشغيل وبنية الكمبيوتر. من التخطيط الكامل للبتات لهيكل جدول الصفحات في معمارية x86-64، إلى بروتوكول IPI لإيقاف TLB، والتتبع الكامل لخطأ الصفحة في نواة Linux، والآلية الفيزيائية للنسخ عند الكتابة (CoW)، وخوارزمية استرداد الذاكرة (Reclaim)، وصولاً إلى صيغة حساب النقاط لـ OOM Killer، سنقوم بشرح الآليات ذات المستوى المنخفض بدقة على مستوى الكود المصدري ومستوى السجلات (Registers).
الفصل الأول: سبب وجود الذاكرة الافتراضية والخلفية التاريخية
لماذا تحتاج أجهزة الكمبيوتر إلى ذاكرة افتراضية؟ في أنظمة الكمبيوتر المبكرة، كانت البرامج تصل مباشرة إلى عناوين محددة في الذاكرة الفعلية (RAM). ومع ذلك، مع انتشار بيئات المهام المتعددة (Multitasking)، وصلت هذه الطريقة المتمثلة في “تحديد العناوين الفعلية مباشرة” إلى حدودها.
1.1 حماية الذاكرة والفصل الكامل لمساحات العمليات
الغرض الأساسي من الذاكرة الافتراضية هو “ضمان الأمن والاستقرار”. إذا قامت العملية (A) عن طريق الخطأ (أو بشكل خبيث) بالكتابة فوق ذاكرة العملية (B)، فقد يتعطل النظام بأكمله أو قد تتسرب معلومات سرية. توفر الذاكرة الافتراضية لكل عملية الوهم بأنها “تمتلك مساحة ذاكرة متجاورة خاصة بها”. ونتيجة لذلك، يتم فصل الذاكرة بين العمليات بشكل صارم على مستوى الأجهزة (MMU)، ويتم اكتشاف الوصول غير المصرح به إلى الذاكرة فورًا ومعالجته كخطأ تجزئة (Segmentation Fault). كما يتم تحقيق الفصل بين مساحة المستخدم ومساحة النواة من خلال هذه الآلية، حيث يتم إجراء انتقالات حلقات الامتياز والتحقق من صلاحيات الوصول إلى الذاكرة بواسطة الأجهزة في كل دورة (Cycle).
1.2 كسر حاجز سعة الذاكرة الفعلية ومفهوم ترقيم الصفحات عند الطلب
ليس من غير المألوف أن يتجاوز مقدار الذاكرة الذي يطلبه التطبيق سعة ذاكرة الوصول العشوائي (RAM) الفعلية المثبتة. توفر الذاكرة الافتراضية مساحة عنونة واسعة أكبر من الذاكرة الفعلية عن طريق حفظ (Swap out) مناطق الذاكرة (الصفحات) غير المستخدمة حاليًا في أجهزة التخزين الثانوية (HDD/SSD)، وقراءتها مرة أخرى (Swap in) عند الحاجة. بالإضافة إلى ذلك، بدلاً من تحميل جميع الأكواد والبيانات في الذاكرة عند بدء تنفيذ البرنامج، يتم تحميلها في الذاكرة فقط عند حدوث وصول إليها. هذا المفهوم المعروف بـ “ترقيم الصفحات عند الطلب (Demand Paging)” يحقق التوازن بين توفير الذاكرة وسرعة التشغيل.
1.3 التحول النموذجي من التجزئة (Segmentation) إلى ترقيم الصفحات (Paging)
في أجهزة x86 المبكرة (مثل 80286)، تم استخدام “التجزئة (Segmentation)"، التي تدير الذاكرة في كتل متغيرة الطول. هذه الطريقة تستخدم سجلات مثل CS (مقطع الكود) و DS (مقطع البيانات) لحساب العناوين المنطقية باستخدام العنوان الأساسي + الإزاحة. ومع ذلك، كانت التجزئة عرضة لإحداث “تجزئة خارجية (External Fragmentation)” وكانت إدارتها معقدة للغاية. لاحقًا، مع ظهور 80386، تم إدخال “ترقيم الصفحات (Paging)"، الذي يدير الذاكرة بكتل ذات طول ثابت (عادة 4 كيلوبايت)، وأصبح هذا هو الاتجاه السائد. تقوم أنظمة التشغيل الحديثة ذات الـ 64 بت (مثل Linux و Windows) بإبطال عمل التجزئة بشكل فعال باستخدام نموذج الذاكرة المسطحة (العنوان الأساسي 0، والحد الأقصى)، وتقوم بإدارة الذاكرة باستخدام ترقيم الصفحات فقط. يُستخدم التجزئة حاليًا فقط لأغراض محدودة جدًا، مثل الإشارة إلى التخزين المحلي للمسار (TLS) باستخدام سجلات (FS/GS).
الفصل الثاني: البنية متعددة المستويات والتخطيط الكامل للبتات لجدول الصفحات في x86-64
في معمارية الـ 64 بت (x86-64/AMD64)، تكون مساحة العناوين الافتراضية شاسعة. في “مساحة العناوين الافتراضية ذات الـ 48 بت” السائدة حاليًا، تستعرض أجهزة MMU جدول صفحات مكون من 4 مستويات.
2.1 مساحة العناوين الافتراضية 48 بت/57 بت وقيود الشكل القانوني (Canonical Form)
يمكن أن تمثل سجلات الـ 64 بت مساحة عنونة واسعة تبلغ 16 إكسابايت، لكن تطبيقات الأجهزة الحالية لا تستخدمها جميعًا لأسباب تتعلق بالتكلفة والتعقيد. في تطبيق الـ 48 بت، يوجد قيد ينص على أن البتات من 47 إلى 63 من العنوان الافتراضي يجب أن تكون جميعها بنفس القيمة (تمديد الإشارة). العناوين التي تلبي هذا القيد تسمى “العناوين القانونية (Canonical Addresses)”.
نتيجة لذلك، تصبح مساحة الذاكرة ذات بنية تحتوي على فجوة كبيرة غير مستخدمة (فجوة غير قانونية) في المنتصف، وتنقسم بدقة إلى مساحة مستخدم في النصف السفلي (0x0000000000000000 إلى 0x00007FFFFFFFFFFF) ومساحة النواة في النصف العلوي (0xFFFF800000000000 إلى 0xFFFFFFFFFFFFFFFF). إذا تم إلغاء مرجعية مؤشر غير صالح (على سبيل المثال، مؤشر ببيانات وصفية مضمنة في البتات العليا)، فإن MMU ستولد فورًا استثناء حماية عامة (#GP) كانتهاك للقانون. في السنوات الأخيرة، بدأت المعالجات بدءًا من Intel Ice Lake في دعم مساحة افتراضية موسعة إلى 57 بت (جدول صفحات من 5 مستويات)، والتي تشكل أساس البنية التحتية السحابية التي تتعامل مع بيتابايت من الذاكرة.
2.2 تفاصيل الهيكل الهرمي لجدول الصفحات المكون من 4 مستويات (PML4, PDPT, PD, PT)
لتحويل عنوان افتراضي 48 بت إلى عنوان فعلي، يستخدم x86-64 أربعة مستويات من جداول الصفحات (هيكل بيانات على شكل شجرة Radix). كل جدول يبلغ حجمه 4 كيلوبايت ويحتوي على 512 إدخالاً بحجم 64 بت (8 بايت) (2^9 = 512). يتم تقسيم العنوان الافتراضي كما يلي، ليعمل كفهرس لكل مستوى:
- البتات 39-47 (9 بت): فهرس PML4 (Page Map Level 4) - المستوى الأعلى. يشير السجل CR3 إلى العنوان الفعلي الأساسي.
- البتات 30-38 (9 بت): فهرس PDPT (Page Directory Pointer Table)
- البتات 21-29 (9 بت): فهرس PD (Page Directory) - هذا هو النهاية في حالة HugePage بسعة 2 ميجابايت.
- البتات 12-20 (9 بت): فهرس PT (Page Table) - الجدول النهائي للصفحات العادية بحجم 4 كيلوبايت.
- البتات 0-11 (12 بت): إزاحة الصفحة (Page Offset) - الإزاحة داخل الصفحة التي بحجم 4 كيلوبايت (4096 بايت).
2.3 تخطيط البتات الـ 64 الكامل لإدخال جدول الصفحات (PTE)
كل إدخال بـ 64 بت في جدول الصفحات ليس مجرد مؤشر لعنوان فعلي، بل هو مجموعة من البيانات الوصفية التي تتحكم في الوصول الدقيق والتحكم في ذاكرة التخزين المؤقت. يوضح التالي التخطيط الكامل للبتات لـ PTE في x86-64 ووظائفه التفصيلية.
- البت 0 [P] Present: إذا كان 1، فهو موجود في الذاكرة الفعلية. إذا كان 0، فتم التبديل للخارج، أو غير مخصص. الوصول إليه عندما يكون 0 يولد استثناء خطأ الصفحة (#PF).
- البت 1 [R/W] Read/Write: إذا كان 0، فهو للقراءة فقط (Read-Only). إذا كان 1، يمكن القراءة/الكتابة (Read/Write). يلعب دورًا مهمًا للغاية في تنفيذ CoW (النسخ عند الكتابة).
- البت 2 [U/S] User/Supervisor: إذا كان 0، فلا يمكن الوصول إليه إلا في وضع الامتياز (النواة). إذا كان 1، يمكن الوصول إليه من وضع المستخدم (Ring 3). تتم إدارته بدقة بواسطة KPTI و SMAP وما إلى ذلك.
- البت 3 [PWT] Page-level Write-Through: إذا كان 1، يتم تعيين سياسة الكتابة لذاكرة التخزين المؤقت لهذه الصفحة على الكتابة المباشرة (Write-Through). إذا كان 0، تكون رد الكتابة (Write-Back).
- البت 4 [PCD] Page-level Cache Disable: إذا كان 1، يتم تعطيل التخزين المؤقت لهذه الصفحة (Uncacheable). يُستخدم عند الوصول المباشر إلى سجلات جهاز PCIe عبر Memory-Mapped I/O (MMIO).
- البت 5 [A] Accessed: يتم تعيينه تلقائيًا إلى 1 بواسطة الأجهزة عندما يقوم MMU بالوصول (قراءة أو كتابة) إلى هذه الصفحة. يتم استخدامه كبت مرجعي في خوارزمية LRU الخاصة بنظام التشغيل (استرداد الصفحة).
- البت 6 [D] Dirty: يتم تعيينه تلقائيًا إلى 1 بواسطة الأجهزة عندما يقوم MMU بـ “الكتابة” على هذه الصفحة. بت ضروري لكي يحدد نظام التشغيل ما إذا كان من الضروري إعادة الكتابة على القرص (Swap out).
- البت 7 [PAT] Page Attribute Table: بالاقتران مع PWT/PCD، يعمل كفهرس لتحديد نوع ذاكرة التخزين المؤقت للذاكرة بشكل أكثر تفصيلاً (مثل WC: Write-Combining). يُستخدم في عمليات النقل بالجملة عالية السرعة إلى ذاكرة الرسومات (VRAM).
- البت 8 [G] Global: إذا كان 1، فلن يتم مسح هذا الإدخال من TLB حتى في حالة تغيير سجل CR3 (عند حدوث تبديل السياق). يُستخدم بشكل أساسي للصفحات في مساحة النواة، متجنباً عقوبة أخطاء TLB أثناء استدعاءات النظام.
- البتات 9-11 [AVL] Available: 3 بتات يمكن لنظام التشغيل (النواة) استخدامها بحرية. في Linux، قد يتم استخدامه كبيانات وصفية لإدخالات التبديل أو لتحديد عقد NUMA.
- البتات 12-51 [PFN] Physical Frame Number: العنوان الأساسي للصفحة الفعلية المستهدفة للتحويل (رقم الإطار الفعلي). نظرًا لمحاذاته بـ 4 كيلوبايت، يتم دائمًا التعامل مع البتات الـ 12 السفلية كأصفار.
- البتات 52-62 [AVL/PKU] Available/Ignored: منطقة محجوزة أو قابلة للاستخدام بواسطة نظام التشغيل اعتمادًا على جيل وحدة المعالجة المركزية وامتدادات الميزات (مثل Intel MPK: Memory Protection Keys).
- البت 63 [XD/NX] Execute-Disable / No-eXecute: إذا كان 1، يجعل البيانات على هذه الصفحة “غير قابلة للتنفيذ كتعليمات”. وهي آلية أمنية قوية (DEP: Data Execution Prevention) لمنع هجمات حقن الأكواد في مناطق البيانات بسبب تجاوز سعة المخزن المؤقت (Buffer Overflow).
بهذه الطريقة، يرتبط كل بت من PTE ارتباطًا وثيقًا بخوارزمية إدارة الذاكرة لنظام التشغيل (خاصة معالجة التبديل، وحماية الأمان، والتحكم في الإدخال/الإخراج)، مما يجعله تصميمًا متطورًا للغاية كواجهة حدودية بين الأجهزة والبرامج.
الفصل الثالث: استعراض جدول الصفحات بالأجهزة عبر MMU وجدار زمن الوصول
يتم إجراء التحويل من العناوين الافتراضية إلى العناوين الفعلية بواسطة دائرة أجهزة مخصصة تسمى MMU (وحدة إدارة الذاكرة) الموجودة داخل نواة وحدة المعالجة المركزية (CPU).
3.1 آلية استعراض الجدول بدءًا من السجل CR3
يحتوي سجل التحكم CR3 الخاص بالمعالج على العنوان الفعلي لجدول الصفحات ذي المستوى الأعلى (PML4) للعملية الجاري تنفيذها حاليًا. عندما يقوم نظام التشغيل مثل Linux بتبديل السياق لنقل حقوق تنفيذ وحدة المعالجة المركزية إلى عملية أخرى، فإنه يقوم بإعادة كتابة سجل CR3 بعنوان PML4 للعملية الجديدة. نتيجة لذلك، يتم تبديل مساحة ذاكرة العملية بأكملها على الفور.
يوضح التالي التدفق المفاهيمي:
- استخراج الفهرس الأعلى للعنوان الافتراضي، وقراءة الإدخال المقابل في جدول PML4 الذي أشار إليه CR3.
- استخراج PFN من إدخال PML4، وحساب العنوان الفعلي لجدول PDPT التالي.
- قراءة الإدخال المقابل لجدول PDPT.
- تتبع جدول PD، ثم جدول PT بشكل مشابه، للحصول على العنوان الأساسي للصفحة الفعلية النهائية بحجم 4 كيلوبايت.
- أخيرًا، إضافة إزاحة الصفحة ذات الـ 12 بت لإنشاء العنوان الفعلي الكامل.
3.2 الوصول إلى ناقل الذاكرة وتأخير الاستجابة (Latency) كأكبر عقبة
تكمن أكبر نقطة ضعف في هذا الاستعراض لجدول الصفحات المكون من 4 مستويات في “تأخير الوصول إلى الذاكرة (Memory Access Latency)”. تحويل عنوان افتراضي واحد فقط سيولد، في أسوأ الحالات، 4 عمليات وصول إلى الذاكرة الفعلية (قراءة PML4 و PDPT و PD و PT). يبلغ زمن وصول الذاكرة الديناميكية (DRAM) الحديثة حوالي 50 إلى 100 نانو ثانية. إذا غابت جميع عمليات الوصول إلى الذاكرة الأربع عن ذاكرة التخزين المؤقت لوحدة المعالجة المركزية (L1/L2/L3) ووصلت إلى DRAM، فسيحدث توقف بمئات من النانو ثانية. بالنظر إلى أن دورة ساعة المعالج تبلغ حوالي 0.3 نانو ثانية (3 جيجاهرتز)، فهذا يمثل تأخيرًا مميتًا يعادل آلاف الدورات، مما يتسبب في توقف خط أنابيب وحدة المعالجة المركزية واستنزافه بالكامل. للتغلب على حاجز الأداء الخطير للغاية هذا، تم تصميم TLB، والذي سيتم شرحه في القسم التالي.
الفصل الرابع: بنية TLB في البيئات متعددة النواة ومعاناة الإيقاف
تعتبر TLB (Translation Lookaside Buffer) بمثابة “ذاكرة تخزين مؤقت لنتائج التحويل من العناوين الافتراضية إلى العناوين الفعلية” والمضمنة في MMU، وتتكون من ذاكرة SRAM فائقة السرعة (أو CAM: Content Addressable Memory).
4.1 الهيكل الهرمي لـ TLB والتحسين عبر PCID (مُعرّف سياق العملية)
في وحدات المعالجة المركزية الحديثة، تمتلك TLB أيضًا هيكلًا هرميًا مثل L1/L2. تتميز L1 D-TLB (للبيانات) و L1 I-TLB (للتعليمات) بسعة صغيرة جدًا (عشرات الإدخالات) لكنها تستجيب في دورة واحدة. تمتلك L2 TLB المئات إلى الآلاف من الإدخالات وتستجيب في دورات قليلة. إذا لم يكن الإدخال موجودًا في TLB (TLB Miss)، فسيحدث استعراض جدول الأجهزة (Page Walk) الموضح سابقًا. لدعم ذلك، تم تنفيذ ذاكرة تخزين مؤقت مخصصة لاستعراض الصفحات (PWC: Page Walk Cache).
نظرًا لأن معنى العناوين الافتراضية يتغير عند تبديل العمليات، في الماضي (في x86 المبكر) كان يتم مسح TLB بالكامل (Flush) عند إعادة كتابة CR3. ومع ذلك، يؤدي هذا إلى أخطاء TLB متكررة فور تبديل السياق، مما يقلل الأداء بشكل كبير. ولحل هذه المشكلة، تم تقديم تقنية PCID (مُعرّف سياق العملية) (تسمى ASID في بنية ARM). من خلال إرفاق معرّف (علامة) مكون من 12 بت يحدد العملية بشكل فريد لكل إدخال في TLB، أصبح من الممكن الاحتفاظ بإدخالات TLB للعملية السابقة حتى بعد تبديل السياق، مما أدى إلى تحسين الأداء بشكل كبير في بيئات العمليات المتعددة مثل خوادم الويب وقواعد البيانات.
4.2 بروتوكول المقاطعة بين المعالجات (IPI) لإيقاف TLB (TLB Shootdown)
في بيئة متعددة النواة، يواجه نظام الذاكرة الافتراضية مشكلة مزامنة مزعجة للغاية. على سبيل المثال، لنفترض أن عملية تعمل على النواة 0 (CPU0) حررت منطقة ذاكرة معينة عبر munmap() وأبطلت PTE في جدول الصفحات (Present = 0). ومع ذلك، في TLB المحلية للنواة 1 (CPU1)، قد لا تزال هناك “معلومات تحويل قديمة (Stale TLB Entry)” من ذلك العنوان الافتراضي إلى العنوان الفعلي كذاكرة تخزين مؤقت.
إذا تُركت النواة 1 على هذه الحالة، فقد تصل إلى الذاكرة المحررة، مما يؤدي إلى ثغرات أمنية خطيرة، مثل تدمير البيانات المخصصة لعمليات أخرى، أو قراءة معلومات سرية. لمنع هذا، يجب على نظام التشغيل إجبار النواة 1 على إزالة الإدخال المعني من TLB الخاص بها. يُعرف هذا بـ TLB Shootdown (إيقاف TLB).
يتم تنفيذ TLB Shootdown بصرامة من خلال الخطوات التالية (بروتوكول IPI):
- البادئ (Initiator) (النواة 0): بعد تحديث جدول الصفحات (مسح PTE)، يُصدر حاجز ذاكرة (مثل
mfence) ويرسل IPI (Inter-Processor Interrupt: مقاطعة بين المعالجات) إلى APIC المحلي الخاص بالنواة المستهدفة (النواة 1). - الانتظار (Busy Wait): تنتظر النواة 0 في حالة “Spinlock” حتى تنتهي جميع النوى المستهدفة الأخرى من معالجة المقاطعة.
- الهدف (Target) (النواة 1): عند تلقي IPI، تقوم النواة 1 فوراً بمقاطعة رمز المستخدم قيد التنفيذ والانتقال إلى معالج مقاطعة النواة (في Linux، مثل
flush_tlb_funcعبرsmp_call_function). - تنفيذ المسح (Flush): تقوم النواة 1 بإبطال إدخال العنوان الافتراضي المحدد من TLB المحلي الخاص بها (تستخدم x86 تعليمة
INVLPG، أو إعادة تحميل CR3 في حالة المسح الكامل). - إشعار الانتهاء: تكتب النواة 1 اكتمال المسح في علامة في الذاكرة، مما ينهي انتظار النواة 0. بعد ذلك، تعود من المقاطعة لاستئناف العملية (
iret).
اختناق الأداء وحدود قابلية التوسع: يعد TLB Shootdown عملية باهظة التكلفة للغاية تستهلك آلاف إلى عشرات الآلاف من الدورات؛ لأنه ينطوي على إصدار IPI للأجهزة، وتبديل سياق المقاطعة، ومسح خط الأنابيب، والانتظار (Spinlock) بين نوى متعددة. كلما زاد عدد النوى، مثل 16 و 64 و 128، ازدادت تكلفة المزامنة هذه بشكل أسي، وأصبحت عاملاً مثبطًا خطيرًا للتوسع بالنسبة للتطبيقات متعددة الخيوط (خاصة تلك التي تخصص وتحرر الذاكرة بشكل متكرر) في الخوادم السحابية والحوسبة عالية الأداء (HPC).
الفصل الخامس: التتبع الكامل لمعالجة خطأ الصفحة في نواة Linux
عندما يصل برنامج ما إلى منطقة يكون فيها بت Present في جدول الصفحات مساويًا لـ 0، أو إلى منطقة لا يمتلك صلاحيات الوصول إليها (مثل محاولة الكتابة في منطقة للقراءة فقط، أو الوصول إلى منطقة النواة من وضع المستخدم)، يصدر MMU استثناء خطأ الصفحة (في x86 هو استثناء 14، #PF). من هنا، تبدأ رحلة عميقة في معالجة الاستثناءات بنواة Linux.
5.1 تدفق التحكم في خطأ الصفحة وتتبع الأجزاء المعتمدة على المعمارية
في نواة Linux لمعمارية x86-64، يكون الرسم البياني لاستدعاء الوظيفة (Call Trace) عند حدوث خطأ صفحة كما يلي. ينتقل التحكم من المعالج منخفض المستوى المعتمد على المعمارية إلى نظام الذاكرة الفرعي العام غير المعتمد على المعمارية.
asm_exc_page_fault(لغة التجميع: arch/x86/entry/entry_64.S)- تكتشف وحدة المعالجة المركزية الاستثناء، وتضع الأجهزة العنوان الافتراضي حيث حدث الخطأ في سجل
CR2، وتحفظ حالة السجلات في مكدس المقاطعة، وتنتقل إلى نقطة الدخول الخاصة بالنواة.
- تكتشف وحدة المعالجة المركزية الاستثناء، وتضع الأجهزة العنوان الافتراضي حيث حدث الخطأ في سجل
exc_page_fault()(لغة C: arch/x86/mm/fault.c)- هذا معالج أخطاء يعتمد على المعمارية. يقوم بتحليل كود الخطأ (قراءة/كتابة، مستخدم/نواة، PF، وما إلى ذلك) والتحقق من سياق المقاطعة.
do_page_fault()/do_user_addr_fault()- يحدد ما إذا كان الخطأ قد حدث في مساحة النواة (أخطاء البرمجة أو مناطق vmalloc، إلخ) أم مساحة المستخدم. إذا كان في مساحة المستخدم، يتم البحث في خريطة الذاكرة للعملية المستهدفة (شجرة أحمر-أسود، قائمة VMA لـ
vm_area_struct) للتحقق مما إذا كان العنوان ينتمي إلى منطقة صالحة (وما إذا لم يكن خطأ تجزئة).
- يحدد ما إذا كان الخطأ قد حدث في مساحة النواة (أخطاء البرمجة أو مناطق vmalloc، إلخ) أم مساحة المستخدم. إذا كان في مساحة المستخدم، يتم البحث في خريطة الذاكرة للعملية المستهدفة (شجرة أحمر-أسود، قائمة VMA لـ
handle_mm_fault()(لغة C: mm/memory.c)- من هنا تبدأ الوظائف الأساسية غير المعتمدة على المعمارية. تقوم بتتبع كل مستوى من جدول الصفحات (PGD -> P4D -> PUD -> PMD -> PTE)، وإذا لم يتم تخصيص الجداول بعد، فإنها تقوم بإنشاء وتخصيص أدلة متوسطة (مثل
pmd_alloc) أثناء تحديد عنوان PTE النهائي.
- من هنا تبدأ الوظائف الأساسية غير المعتمدة على المعمارية. تقوم بتتبع كل مستوى من جدول الصفحات (PGD -> P4D -> PUD -> PMD -> PTE)، وإذا لم يتم تخصيص الجداول بعد، فإنها تقوم بإنشاء وتخصيص أدلة متوسطة (مثل
5.2 جوهر تخصيص الذاكرة: التفرعات من handle_mm_fault
تقوم وظيفة handle_mm_fault() بتفريع عملية تخصيص الصفحة الفعلية بناءً على حالة PTE التي تم تحديدها (ما إذا كان PTE فارغًا، أو تم تبديله للخارج، أو خطأ في الصلاحيات).
do_anonymous_page()(أقصى درجات ترقيم الصفحات عند الطلب): يتم استدعاؤها عندما يكون PTE فارغًا تمامًا (أصفار). هذا هو الوصول الأول إلى صفحة مجهولة (Anonymous Page) غير مرتبطة بملف، مثل توسيع الكومة (Heap) (brkأوmmapخلفmalloc) أو المكدس. في هذه المرحلة، تقوم النواة لأول مرة بتأمين ذاكرة فعلية (إطار) من نظام الأصدقاء (Buddy System)، وتقوم بمسحها بالصفر وتعيينها في PTE. هذا يحافظ على الذاكرة غير المستخدمة.do_fault()/__do_fault()(ترقيم الصفحات المدعوم بملف): يتم استدعاؤها عند الوصول الأول إلى ملف تم تعيينه عبرmmap. تقرأ بيانات الملف من ذاكرة التخزين المؤقت للصفحات، أو تستدعي مشغل نظام الملفات (ext4 أو xfs) لتحميل البيانات من القرص، وتعيينها في جدول الصفحات.do_swap_page()(ألم التبديل للداخل): يتم استدعاؤها عندما يكون بت Present في PTE مساويًا لـ 0، ولكن يتم تسجيل معلومات الإزاحة لمنطقة التبديل في بتات أعلام أخرى. تعيد تحميل البيانات من القرص (قسم التبديل أو ملف التبديل) إلى الذاكرة الفعلية. نظرًا لأنه يتضمن إدخالاً/إخراجاً للقرص (Disk I/O)، تدخل العملية في حالة نوم (توقف - Block) لفترة طويلة هنا.do_wp_page()(النسخ عند الكتابة - Copy-on-Write): هذه هي عملية CoW التي سيتم شرحها لاحقًا. يتم استدعاؤها عندما يكون Present=1، ولكن يحاول البرنامج الكتابة في صفحة ليس لديه صلاحية الكتابة فيها.
5.3 الآلية الفيزيائية لـ النسخ عند الكتابة (CoW) وسحر عداد المراجع
يعمل استدعاء النظام fork()، والذي يمثل حجر الزاوية في إنشاء العمليات في Linux، بسرعة قصوى بفضل آلية التقييم المؤجل المسماة CoW (Copy-on-Write). سنشرح الآلية الفيزيائية خلف كيفية اكتمال fork() في لحظة حتى لو كانت العملية الأم تستخدم عدة جيجابايت من الذاكرة.
- مشاركة جداول الصفحات:
عندما يتم استدعاء
fork()، تقوم النواة بنسخ جدول صفحات العملية الأم كما هو إلى العملية الابن. ومع ذلك، لا تنسخ الذاكرة الفعلية نفسها أبدًا. تشير كل من PTE الخاصة بالأب والابن إلى نفس الذاكرة الفعلية (الإطار) تمامًا. - الفرض الإجباري لبت القراءة فقط (Write-Protect):
في هذا الوقت، تقوم النواة بإعادة كتابة بت
R/Wبقوة إلى0(للقراءة فقط) لجميع الصفحات المشتركة (بما في ذلك مناطق البيانات التي كانت قابلة للكتابة في الأصل). - زيادة عداد المراجع (Reference Count):
تزيد النواة من عداد مراجع هيكل النواة الذي يدير الصفحة الفعلية المستهدفة (
_refcountلـstruct page)، مما يشير إلى أن “هذه الصفحة يُشار إليها من قِبل عمليتين”. - الكتابة وخطأ الصفحة (تفعيل do_wp_page):
إذا حاول الأب أو الابن الكتابة (Write) في منطقة ذاكرة مشتركة (متغيرات أو Heap)، سيكتشف MMU للأجهزة أن
R/W=0وسيولد خطأ صفحة فورًا. - استنساخ الصفحة (Duplication):
يتم استدعاء
do_wp_page()من معالج خطأ الصفحة. تتحقق النواة من علامات VMA، وتقرر: “هذا ليس وصولًا غير مصرح به، بل هو خطأ CoW صالح”. تقوم بتأمين صفحة فعلية جديدة واحدة من نظام الأصدقاء (Buddy System) وتنسخ بيانات الصفحة الأصلية بالكامل (copy_page). - تحديث PTE وتقليل عداد المراجع:
تعيد توجيه PTE للعملية التي قامت بالكتابة إلى الصفحة الفعلية الجديدة، وتعيّن بت
R/Wإلى1(قابل للقراءة/الكتابة). ثم ينخفض عداد المراجع للصفحة الفعلية الأصلية. إذا أصبح عداد المراجع 1، فهذا يعني أن العملية الأخرى تحتكر تلك الصفحة، لذلك في المرة القادمة التي تتسبب فيها هذه العملية في حدوث خطأ، لا تحتاج النواة إلى نسخ الذاكرة، ولكن ببساطة إعادة تعيين بت R/W إلى 1 (إعادة استخدام الصفحة).
بهذه الطريقة، تعد CoW خوارزمية فنية تدمج بشكل رائع ميزات حماية الأجهزة (فخ القراءة فقط) في MMU وتحكم النواة في البرامج، مما يحقق توفيرًا جذريًا في الذاكرة وبدءًا سريعًا للعمليات.
الفصل السادس: أعماق خوارزمية استرداد الذاكرة (Reclaim) وإدانة OOM Killer
الذاكرة الفعلية محدودة. عندما يعمل النظام لفترة طويلة، وتستهلك التخزين المؤقت للملفات وأكوام العمليات الذاكرة المتبقية، يجب على نظام التشغيل تحرير واسترداد (Reclaim) مناطق الذاكرة الموجودة من أجل تخصيص ذاكرة جديدة. يُعد النظام الفرعي لاسترداد الذاكرة هذا واحدًا من أكثر المناطق تعقيدًا وصعوبة في نواة Linux.
6.1 القوائم النشطة/غير النشطة في LRU وخوارزمية LRU الزائفة
تستخدم نواة Linux قوائم LRU (Least Recently Used) لإدارة وتتبع الصفحات الفعلية. ومع ذلك، من المستحيل إدارة جميع الصفحات باستخدام LRU صارم بسبب تعارض القفل وتكلفة الاستعراض. لذلك، تعتمد النواة على خوارزمية LRU الزائفة (مشتقة من خوارزمية الساعة - Clock Algorithm) تستخدم طابورين (قائمتين): “القائمة النشطة” و “القائمة غير النشطة”.
- القائمة النشطة (Active List): مجموعة من الصفحات “الساخنة” التي يتم الوصول إليها بشكل متكرر مؤخرًا. هذه الصفحات ليست هدفًا للاسترداد.
- القائمة غير النشطة (Inactive List): مجموعة من الصفحات “الباردة” التي لم يتم الوصول إليها لفترة من الوقت. تصبح مرشحة للاسترداد بالترتيب من ذيل (Tail) القائمة.
كيف تعرف النواة ما إذا تم الوصول إلى الصفحة أم لا؟ هنا يأتي دور بت تم الوصول إليه (A - Accessed Bit) في PTE، والذي تم شرحه في الفصل الثاني. يستعرض خيط النواة (kswapd) جداول الصفحات بشكل دوري، ويقرأ بت A من PTE، ويسجل سجل الوصول على جانب البرنامج، ثم يمسح بت A ليصبح 0. إذا تم تعيين بت A مرة أخرى إلى 1 بواسطة الأجهزة، فستبقى الصفحة في القائمة النشطة أو تتم ترقيتها من القائمة غير النشطة. إذا لم يتم تعيينه، فسيتم خفضه تدريجيًا إلى ذيل القائمة غير النشطة.
6.2 خفي kswapd ورعب الاسترداد المباشر (Direct Reclaim)
عندما تنخفض المساحة الحرة للذاكرة (Free Pages) إلى ما دون حد معين (علامة مائية: low)، يستيقظ kswapd، وهو خيط خلفية في النواة (موجود لكل عقدة NUMA).
يقوم kswapd بإخراج الصفحات من ذيل القائمة غير النشطة.
- إذا كانت ذاكرة تخزين مؤقت نظيفة لملف (بيانات ملف لم يتم تعديلها)، فإنه ببساطة يسقطها (Drop) لتحرير الذاكرة.
- إذا كانت ذاكرة تخزين مؤقت قذرة لملف (تم تعديلها)، فإنه يكتبها مرة أخرى على القرص (Writeback) قبل إسقاطها.
- إذا كانت صفحة مجهولة (كومة أو مكدس العملية)، فإنه يكتبها في منطقة التبديل (Swap out).
ويستمر في هذا العمل في الخلفية حتى تصل سعة المساحة الحرة إلى العلامة المائية
high.
ومع ذلك، عندما يكون معدل طلب التطبيق للذاكرة (Memory Pressure) مرتفعًا جدًا ولا يمكن لسرعة الاسترداد بواسطة kswapd المواكبة، وتنخفض الذاكرة الحرة إلى الحد الأقصى (العلامة المائية min)، يتم تنشيط الاسترداد المباشر (Direct Reclaim).
الاسترداد المباشر هو آلية يتم فيها تنفيذ عملية استرداد الذاكرة (إسقاط ذاكرة التخزين المؤقت أو التبديل للخارج) بشكل متزامن داخل سياق العملية (التطبيق نفسه) الذي طلب الذاكرة. عند الدخول في الاسترداد المباشر، يتوقف تنفيذ التطبيق (إكمال malloc أو خطأ الصفحة) تمامًا (Stall)، مما يسبب تباطؤًا شديدًا (Latency Spike) يمتد لمئات الملي ثانية إلى عدة ثوانٍ. في قواعد البيانات والأنظمة في الوقت الفعلي، من الضروري ضبط النظام لتجنب ذلك (مثل ضبط vm.swappiness والعلامات المائية).
6.3 صيغة حساب OOM Killer وإدانة العمليات
إذا استُنفدت منطقة التبديل، ومُسحت ذاكرة التخزين المؤقت، ولم يكن بالإمكان تأمين أي ذاكرة حتى مع الاسترداد المباشر، تستدعي نواة Linux OOM (Out Of Memory) Killer كخيار أخير.
لمنع النظام بأكمله من الدخول في حالة من الذعر (انهيار النواة أو التجمد الكامل) بسبب نقص الذاكرة، يقوم OOM Killer بـ “الإنهاء الإجباري (SIGKILL)” للعمليات التي تستهلك كميات كبيرة من الذاكرة لاستعادتها. هناك خوارزمية لا ترحم تحدد الضحية.
يتم تحديد العملية التي سيتم قتلها بناءً على قيمة التقييم oom_score (محسوبة بواسطة الدالة oom_badness() في mm/oom_kill.c الخاص بالنواة).
المنطق الأساسي لحساب OOM Score (نظرة عامة):
- النتيجة الأساسية: النسبة المئوية لإجمالي الذاكرة التي تستخدمها العملية حاليًا (RSS: حجم المجموعة المقيمة + حجم جدول الصفحات + مقدار استخدام التبديل). بحد أقصى 1000 نقطة. بعبارة أخرى، كلما زاد استهلاك العملية للذاكرة (مثل العمليات التي تسبب تسرب الذاكرة)، زادت احتمالية تعرضها للقتل.
- تخفيف عقوبة امتيازات الجذر (Root): من المرجح أن تكون العمليات التي تعمل بامتيازات مستخدم الجذر (مثل خفي النواة الأساسي) ضرورية لصيانة النظام، لذا يتم خصم (طرح) قليل من درجاتها، مما يجعل قتلها أقل احتمالية.
- قيمة تعديل المستخدم (OOM Score Adj): يضاف إليها قيمة
/proc/[pid]/oom_score_adj(من -1000 إلى +1000). يمكن لمسؤولي النظام استخدام هذا للتحكم في سلوك OOM Killer. العملية التي يتم تعيين هذه القيمة لها على -1000 (على سبيل المثال: sshd، و kubelet، والعمليات الرئيسية لقاعدة البيانات، وما إلى ذلك) تكون “معفاة من OOM Killer (لا تُقهر)”.
عندما يتم تشغيل OOM Killer، يتم طباعة رسالة مثل “Out of memory: Killed process 1234 (java)” في سجل النواة (dmesg أو /var/log/messages)، إلى جانب تفريغ مفصل لقائمة العمليات والنتائج وحالة الذاكرة في ذلك الوقت. يمكن لمسؤولي النظام فهم هذه السجلات وآليات حساب النقاط للتحقيق في أسباب الإنهاء غير المتوقع للعمليات، وتعيين قيود الموارد المناسبة (cgroups و ulimit).
الفصل السابع: أحدث تقنيات الذاكرة فائقة السرعة وأمن الأجهزة
7.1 قوة 2MB/1GB HugePages وإيجابيات وسلبيات THP
تعد “HugePage” وسيلة قوية لحل مشكلة أخطاء TLB وتأخيرات استعراض الجداول الموضحة في الفصلين الثالث والرابع. بدلاً من صفحات 4 كيلوبايت العادية، تستخدم صفحات ضخمة بسعة 2 ميجابايت (تشير مباشرة إلى العنوان الفعلي في مرحلة دليل الصفحات (Page Directory)، أي يتم تخطي مستوى PT) أو 1 جيجابايت (تشير مباشرة في مرحلة PDPT).
نتيجة لذلك، يمكن لإدخال TLB واحد أن يغطي مساحة ذاكرة هائلة (512 مرة، أو 260,000 مرة حجم صفحة الـ 4 كيلوبايت)، مما يقلل بشكل كبير من أخطاء TLB. في قواعد البيانات (Oracle و PostgreSQL) أو البيئات الافتراضية (KVM/QEMU) التي تصل بشكل عشوائي إلى كميات كبيرة من الذاكرة، أصبح استخدام HugePage عنصرًا أساسيًا لضبط الأداء.
في Linux، ميزة THP (Transparent Huge Pages) هي آلية يقوم من خلالها خيط خلفية النواة (khugepaged) تلقائيًا بدمج (Defragmentation) صفحات 4 كيلوبايت المتتالية في HugePages بسعة 2 ميجابايت، دون أن يدرك التطبيق ذلك. ومع ذلك، في بيئة بها تجزئة عالية في الذاكرة، تستهلك عملية الدمج هذه (ضغط الذاكرة) الكثير من طاقة وحدة المعالجة المركزية، وتسبب ارتفاعًا في زمن الوصول (Latency Spikes)، لذا يُوصى بتعطيل THP (never أو عبر madvise) في أنظمة KVS داخل الذاكرة مثل Redis.
7.2 عزل جدول صفحات النواة (KPTI) وتكلفة التدابير ضد Meltdown
كانت ثغرة التنفيذ التكهني في وحدات المعالجة المركزية المسماة “Meltdown (CVE-2017-5754)"، والتي اكتُشفت في عام 2018، عيبًا فادحًا هز أساسيات الأجهزة حيث سمحت للعمليات في مساحة المستخدم بقراءة ذاكرة النواة (ذاكرة التخزين المؤقت) بشكل غير قانوني.
كإجراء مضاد تم تقديمه على جانب نظام التشغيل، تم تطبيق KPTI (عزل جدول صفحات النواة) (يُعرف في البداية بـ KAISER).
في الماضي، ولتقليل أعباء تبديل السياق، كان يتم تعيين منطقة النواة بأكملها في النصف العلوي من جدول الصفحات حتى أثناء التنفيذ في مساحة المستخدم (كان يُفترض أن يتم إجراء فحص الامتيازات بواسطة بت U/S في PTE ويُرفض الوصول). ومع ذلك، تجاوز التنفيذ التكهني فحص الامتيازات هذا.
بعد تطبيق KPTI، يتم استخدام “جدول صفحات ظل بأدنى حد ممكن (User PGD)” لا يقوم بتعيين معظم أجزاء النواة أثناء تنفيذ وضع المستخدم. عندما تنتقل إلى مساحة النواة بواسطة استدعاء نظام أو مقاطعة، يصبح من الضروري دائمًا تبديل سجل CR3 لإعادة تحميل جدول صفحات النواة الكامل (Kernel PGD).
ضمن هذا الأمان بالكامل، ولكنه أدخل تبديلات CR3 باهظة التكلفة (وإدارة مسح PCID/TLB) في كل مرة يتم فيها استدعاء النظام أو المقاطعة، مما أدى إلى نفقات إضافية في الأداء لا يمكن تجاهلها (تصل إلى عدة في المائة أو أكثر من 10٪) للتطبيقات المكثفة الإدخال/الإخراج (I/O Intensive) (مثل خوادم الويب أو قواعد البيانات التي تعتمد بكثرة على Syscall).
7.3 الإدخال/الإخراج المباشر (Direct I/O) وتطور تقنية الصفر-نسخ (Zero-copy)
لتحسين الإدخال/الإخراج (I/O) للملفات، يطبق نظام التشغيل آليات الذاكرة الافتراضية إلى أقصى حد.
عند استخدام استدعاء النظام mmap()، يتم تعيين محتويات الملف مباشرة إلى مساحة العناوين الافتراضية. عند الوصول إليها، يحدث خطأ صفحة، وتُقرأ بيانات الملف في ذاكرة التخزين المؤقت للصفحات (Page Cache)، وتصبح قابلة للوصول مباشرة كمؤشر من مساحة المستخدم.
علاوة على ذلك، في عمليات إرسال/استقبال الشبكة والإدخال/الإخراج للتخزين، يتم استخدام تقنية الصفر-نسخ (Zero-copy) لتجنب نسخ البيانات بواسطة وحدة المعالجة المركزية (وهو نسخ يصاحبه تبديل سياق) بين مساحة النواة (ذاكرة التخزين المؤقت للصفحات) والمخازن المؤقتة (Buffers) في مساحة المستخدم. من خلال استدعاء النظام sendfile()، و io_uring الحديث، و AF_XDP، تقوم النواة بالتنسيق مع وحدة التحكم DMA (الوصول المباشر للذاكرة) الخاصة ببطاقات NIC أو أقراص NVMe، والتلاعب بـ PTE في جدول الصفحات لـ “إعادة تعيين (Remap)” صفحات النواة مباشرة إلى مساحة المستخدم، مما يقلل نفقات نسخ الذاكرة إلى الصفر تمامًا. هنا أيضًا، كآلية أساسية، يتم تنفيذ التلاعب الذكي بجدول الصفحات.
الخاتمة
الذاكرة الافتراضية وآلية ترقيم الصفحات عبارة عن سيمفونية متطورة للغاية تُعزف بواسطة نواة نظام التشغيل ووحدة المعالجة المركزية (الأجهزة). بدءًا من إعداد علامة بت واحد في جدول الصفحات، والمعاناة من Spinlock المتعلق بـ TLB Shootdown، وسحر الذاكرة بعداد مراجع CoW، وصولاً إلى أساليب OOM Killer التي لا ترحم؛ تحتوي الأعماق على حكمة علوم الكمبيوتر حول “كيفية تلخيص الموارد المادية المحدودة بأمان وسرعة عالية، ومنح العمليات وهمًا باللانهائية”.
يعد فهم الآليات منخفضة المستوى أمرًا ضروريًا ليس فقط لتحسين لغات برمجة الأنظمة مثل C/C++ و Rust (مثل تصميم هياكل البيانات مع مراعاة خط ذاكرة التخزين المؤقت، والاستخدام الفعال لـ mmap)، بل وأيضًا للفهم العميق لأوقات التوقف (STW) لتجميع القمامة (GC) وسلوك مخصصات الذاكرة (مثل jemalloc و tcmalloc) في اللغات عالية المستوى مثل Go و Java. من خلال كشف ستار “السحر” في النظام والشعور بـ نبضات الأجهزة والنواة بشكل مباشر، سيُفتح لك الطريق لتصبح مهندسًا معماريًا ممتازًا قادرًا على تصميم برامج أكثر تطورًا وقابلية للتوسع.