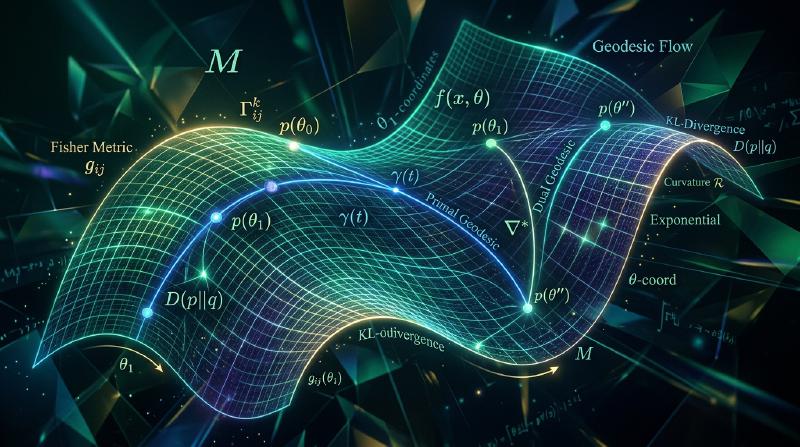
هندسة المعلومات (Information Geometry) هي نظرية عالمية انطلقت من اليابان، تقوم بإدخال بنية الهندسة التفاضلية إلى الفضاء الذي تشكله التوزيعات الاحتمالية، وتكشف جوهر الاستدلال الإحصائي، والتعلم الآلي، ونظرية المعلومات بناءً على الحدس الهندسي. هذه النظرية التي نظمها الدكتور شونيتشي أماري وآخرون، يتم تطبيقها الآن في مجالات واسعة مثل طريقة الانحدار الطبيعي (Natural Gradient Descent) التي تدعم أسس الذكاء الاصطناعي والتعلم العميق، بالإضافة إلى نظرية المعلومات الكمومية والفيزياء الإحصائية، وبدأت تؤسس مكانتها كـ “لغة مشتركة” في العلوم الحديثة.
في هذا المقال، سنشرح هذا العالم العميق لهندسة المعلومات بشكل مفصل ومنهجي قدر الإمكان، مع الجمع بين الدقة الرياضية، والحدس الهندسي، وأمثلة حسابية ملموسة. لن يقتصر الأمر على سرد المعادلات، بل سيبدأ من الأسئلة الجذرية مثل “لماذا فضاء التوزيعات الاحتمالية منحني؟” و “لماذا تصبح مصفوفة معلومات فيشر موترًا متريًا (Metric Tensor)؟"، وصولاً إلى الروابط المزدوجة، وهندسة الإنتروبيا، وتطبيقاتها في أحدث تقنيات التعلم الآلي وعلم الأعصاب، ليرسم الصورة الكاملة لهندسة المعلومات.
الفصل الأول: فجر هندسة المعلومات وحدس شونيتشي أماري
من إحصاء الفضاء الإقليدي إلى الفضاء المنحني للتوزيعات الاحتمالية
في الإحصاء الكلاسيكي وتحليل البيانات، تعاملنا لا شعورياً مع البيانات كنقاط في فضاء إقليدي. على سبيل المثال، عند التفكير في نموذج إحصائي يحتوي على معلمات $\theta = (\theta_1, \theta_2, \dots, \theta_n)$، غالباً ما يتم اعتبار فضاء المعلمات كفضاء مسطح، وتقاس المسافة بين المعلمات باستخدام المسافة الإقليدية العادية. تعتمد طريقة المربعات الصغرى التي تقلل الخطأ التربيعي أيضاً على هذا الحدس الهندسي الإقليدي.
ولكن، هل الفضاء الذي يُحدد معلمات التوزيعات الاحتمالية “مسطح” حقاً؟
لنأخذ التوزيع الطبيعي $N(\mu, \sigma^2)$ كمثال. فضاء المعلمات هو نصف المستوى العلوي $\{(\mu, \sigma^2) \in \mathbb{R} \times \mathbb{R}_{>0}\}$ المكون من المتوسط $\mu$ والتباين $\sigma^2 > 0$. هنا، دعونا نفكر في زوجين من التوزيعات الطبيعية:
- $N(0, 1)$ و $N(0.1, 1)$
- $N(0, 100)$ و $N(0.1, 100)$
إذا نظرنا إلى المسافة الإقليدية للمعلمات، فإن المسافة في كلا الزوجين متساوية وتبلغ $0.1$. ولكن، ماذا عن وجهة نظر “القدرة على التمييز” أو “الاختلاف في المعلومات” كتوزيعات احتمالية؟ عندما يكون التباين صغيراً بـ $1$، فإن انزياح المتوسط بمقدار $0.1$ فقط يغير شكل التوزيع بشكل ملحوظ، ويكون من السهل نسبياً التمييز بينهما من البيانات. من ناحية أخرى، عندما يكون التباين كبيراً جداً بـ $100$، يكون التوزيع مفلطحاً وممتداً، وحتى مع انزياح المتوسط بمقدار $0.1$ فإن التداخل بين التوزيعين يكون كبيراً جداً، مما يجعل التمييز بينهما من البيانات أمراً بالغ الصعوبة.
أي أن “الاختلاف الأصلي كتوزيع” لا يتطابق مع المسافة الإقليدية للمعلمات. في المناطق ذات التباين الكبير، التغيرات الطفيفة في المتوسط بالكاد تؤثر على شكل التوزيع، بينما في المناطق ذات التباين الصغير، تُحدث تغييرات جذرية. هذا يشير بقوة إلى أن فضاء معلمات التوزيع الاحتمالي ليس متجانساً، بل هو “فضاء منحني (متعدد طيات ريماني - Riemannian Manifold) تختلف فيه مقاييس المسافة حسب الموقع”.
لماذا تعتبر عائلة التوزيعات الاحتمالية متعدد طيات؟
تقوم هندسة المعلومات بصياغة النماذج الإحصائية (عائلات التوزيعات الاحتمالية) كمتعدد طيات قابل للتفاضل (Differentiable Manifold).
لنفترض أن $S$ هي عائلة التوزيعات الاحتمالية على فضاء احتمالي $\mathcal{X}$. عندما يتم تحديد هذه العائلة بشكل فريد من خلال $n$ من المعلمات الحقيقية المستمرة $\theta = (\theta^1, \dots, \theta^n)$، وتكون دالة الكثافة الاحتمالية $p(x; \theta)$ سلسة بالنسبة لـ $\theta$، فإننا نطلق على $S$ اسم متعدد طيات إحصائي (Statistical Manifold) ذو $n$ بُعد.
$$ S = \{ p(x; \theta) \mid \theta \in \Theta \subset \mathbb{R}^n \} $$هنا، $\theta$ ليس سوى “نظام إحداثيات محلي (Local Coordinate System)” على متعدد الطيات $S$. في نظرية متعددات الطيات، لا يعد نظام الإحداثيات أمراً جوهرياً، بل هو مجرد طريقة للتعبير. على سبيل المثال، في حالة التوزيع الطبيعي، يمكن اختيار $(\mu, \sigma^2)$ كمعلمات، ويمكن أيضاً اختيار $(\mu, \sigma)$ أو $(\frac{\mu}{\sigma^2}, -\frac{1}{2\sigma^2})$.
جوهر هندسة المعلومات يكمن في “الكشف عن البنية الهندسية الداخلية لعائلة التوزيعات الاحتمالية بحد ذاتها، والتي لا تعتمد على طريقة اختيار نظام الإحداثيات”. قام شونيتشي أماري بتعميق مفهوم “متعدد طيات ريماني الذي يتخذ مصفوفة معلومات فيشر كمقياس” والذي اقترحه C.R. Rao، ومن خلال إدخال مفهوم الرابط التآلفي (Affine Connection)، اكتشف بنية غنية في فضاء التوزيعات الاحتمالية لا تقتصر على “درجة الانحناء (Curvature)” بل تمتد إلى “مفهوم الخطوط المستقيمة (الجيوديسية)” و “الازدواجية (Duality)”.
الفصل الثاني: النموذج الإحصائي كمتعدد طيات ريماني
لتعريف “المسافة” و “الزاوية” في متعدد الطيات، نحتاج إلى مقياس ريماني (Riemannian Metric). ما هو المقياس الريماني الطبيعي في متعدد الطيات الإحصائي؟
دالة النتيجة ومصفوفة معلومات فيشر
في الإحصاء، يسمى التفاضل الجزئي لدالة اللوغاريتم للاحتمالية $\log p(x; \theta)$ بالنسبة للمعلمات بـ “دالة النتيجة (Score Function)"، وتلعب دوراً مهماً.
$$ \partial_i \ell(x; \theta) = \frac{\partial}{\partial \theta^i} \log p(x; \theta) $$$$ E_\theta[\partial_i \ell(x; \theta)] = \int \frac{\partial p(x; \theta)}{\partial \theta^i} dx = \frac{\partial}{\partial \theta^i} \int p(x; \theta) dx = 0 $$$$ g_{ij}(\theta) = E_\theta \left[ \partial_i \ell(x; \theta) \partial_j \ell(x; \theta) \right] $$لاحظ C.R. Rao (1945) أن مصفوفة معلومات فيشر هذه هي مصفوفة متماثلة موجبة محددة تلبي قواعد التحويل للموترات، واقترح استخدامها كمقياس ريماني (مقياس فيشر) لمتعدد الطيات الإحصائي.
$$ ds^2 = \sum_{i,j} g_{ij}(\theta) d\theta^i d\theta^j $$وبهذا يصبح النموذج الإحصائي متعدد طيات ريماني $(S, G)$. تُقاس “مربع المسافة” المتناهية الصغر بين توزيعين احتماليين متقاربين $p(x; \theta)$ و $p(x; \theta + d\theta)$ بواسطة مقياس فيشر هذا.
نظرية تشينتسوف كمقياس ثابت
لماذا يجب اختيار مصفوفة معلومات فيشر كمقياس؟ هذا ليس مجرد فكرة عابرة، بل هناك ضرورة رياضية عميقة وراء ذلك.
قام N.N. Chentsov (1972) بصياغة “اللاتباين (Invariance)” المطلوب في إطار الاستدلال الإحصائي. يجب ألا تتغير نتائج الاستدلال الإحصائي باختلاف طرق تمثيل البيانات أو التحويلات إلى إحصاءات كافية (خرائط ماركوف). أظهرت نظرية تشينتسوف حقيقة مذهلة وهي أن “في متعدد الطيات المكون من التوزيعات الاحتمالية على مجموعة منتهية، المقياس الريماني الوحيد الذي يلبي شرط الرتابة (الانكماشية) تحت خرائط ماركوف هو مقياس معلومات فيشر، باستثناء مضروب ثابت”.
بمعنى آخر، في فضاء التوزيعات الاحتمالية، الطريقة الوحيدة لقياس المسافة التي تلبي المتطلب الإحصائي الطبيعي بـ “عدم نقصان المعلومات” هي مقياس فيشر. هذا يثبت أن مقياس فيشر هو بنية هندسية داخلية وحتمية خاصة بعلم الإحصاء.
مثال حسابي محدد لمقياس فيشر في عائلة التوزيع الطبيعي
$$ p(x; \mu, \sigma) = \frac{1}{\sqrt{2\pi}\sigma} \exp\left(-\frac{(x-\mu)^2}{2\sigma^2}\right) $$$$ \log p = -\log(\sqrt{2\pi}) - \log\sigma - \frac{(x-\mu)^2}{2\sigma^2} $$$$ \partial_\mu \log p = \frac{x-\mu}{\sigma^2}, \quad \partial_\sigma \log p = -\frac{1}{\sigma} + \frac{(x-\mu)^2}{\sigma^3} $$$$ g_{\mu\mu} = E\left[ \left(\frac{x-\mu}{\sigma^2}\right)^2 \right] = \frac{1}{\sigma^2} $$$$ g_{\sigma\sigma} = E\left[ \left(-\frac{1}{\sigma} + \frac{(x-\mu)^2}{\sigma^3}\right)^2 \right] = \frac{2}{\sigma^2} $$$$ g_{\mu\sigma} = g_{\sigma\mu} = 0 $$$$ ds^2 = \frac{1}{\sigma^2} d\mu^2 + \frac{2}{\sigma^2} d\sigma^2 $$هذا يتطابق تماماً (باستثناء اختلاف مضروب ثابت) مع مقياس نصف المستوى العلوي لبوانكاريه، وهو نموذج للهندسة الزائدية (Hyperbolic Geometry، نوع من الهندسة غير الإقليدية) الذي اقترحه هنري بوانكاريه. أي أنه يتضح أن فضاء التوزيع الطبيعي هو فضاء زائدي ذو انحناء ثابت سالب. كما توقعنا حدسياً سابقاً، في المنطقة التي يكون فيها $\sigma$ كبيراً (التباين كبيراً)، يصبح الموتر المتري $1/\sigma^2$ صغيراً، وتدعم المعادلات أن تقلبات المعلمات تُقيَّم كـ “مسافة” صغيرة.
الفصل الثالث: الروابط المزدوجة وأعماق الرابط $\alpha$
بالمقياس الريماني وحده، لا يمكن وصف “درجة الانحناء” للمكان بشكل كامل. نحن بحاجة إلى رابط تآلفي (Affine Connection) يحدد “أي اتجاه هو المستقيم”. يكمن الإنجاز الأكبر لأماري في اكتشافه أن هناك عدداً لا نهائياً من الروابط الطبيعية في متعدد الطيات الإحصائي، وأنها تشكل بنية جميلة تسمى “الازدواجية (Duality)”.
تعريف الرابط $\alpha$
قدم أماري عائلة من الروابط التآلفية تسمى الروابط $\alpha$ باستخدام المعلمة الحقيقية $\alpha$. يتم تعريف معاملات الارتباط $\Gamma_{ij,k}^{(\alpha)}$ الخاصة بها على النحو التالي.
$$ \Gamma_{ij,k}^{(\alpha)} = E \left[ \left( \partial_i \partial_j \ell + \frac{1 - \alpha}{2} \partial_i \ell \partial_j \ell \right) \partial_k \ell \right] $$الرابط $0$ عندما تكون $\alpha = 0$ يتطابق مع رابط ليفي-سيفيتّا (Levi-Civita Connection) المحدد بشكل فريد من مقياس فيشر. هذا هو الرابط المستخدم في الهندسة الريمانية العادية. ومع ذلك، فإن الروابط التي تلعب الدور الأهم في هندسة المعلومات هي عندما تكون $\alpha = 1$ و $\alpha = -1$.
الرابط e والرابط m، والفضاء المسطح المزدوج
- الرابط e (رابط أسي $\alpha = 1$): هو رابط يظهر بشكل طبيعي عند التعامل مع عائلة التوزيعات الأسية (Exponential Family).
- الرابط m (رابط خليط $\alpha = -1$): هو رابط يظهر بشكل طبيعي عند التعامل مع عائلة التوزيعات المختلطة (Mixture Family).
هذان الرابطان في علاقة “مزدوجة (Dual)” بالنسبة لمقياس فيشر $g_{ij}$. في متعدد الطيات الريماني، عندما يتم التعبير عن تفاضل الجداء الداخلي (المقياس) لحقلي متجهات كمجموع التفاضلات المتغيرة بواسطة كل رابط، فإنهما يسميان روابط مزدوجة.
$$ X \langle Y, Z \rangle = \langle \nabla_X^{(e)} Y, Z \rangle + \langle Y, \nabla_X^{(m)} Z \rangle $$ما يستحق الذكر هو حقيقة أن فضاء عائلة التوزيعات الأسية (مثل التوزيع الطبيعي، توزيع بواسون، توزيع غاما، وما إلى ذلك) يكون “مسطحاً (موتر الانحناء يساوي صفر)” بالنسبة للرابط e، وفي نفس الوقت يكون “مسطحاً” بالنسبة للرابط m. يسمى مثل هذا الفضاء بالفضاء المسطح المزدوج (Dually Flat Space).
في الفضاء المسطح المزدوج، يوجد خط مستقيم بالنسبة للرابط e (جيوديسية e) وخط مستقيم بالنسبة للرابط m (جيوديسية m). علاوة على ذلك، في هذه الفضاءات كنظام معلمات، توجد أنظمة إحداثيات مزدوجة (المعلمات الطبيعية $\theta$ ومعلمات القيمة المتوقعة $\eta$) مرتبطة ببعضها البعض بواسطة تحويل ليجاندر (Legendre Transformation).
نظرية فيثاغورس المعممة
تتلخص جمالية الفضاء المسطح المزدوج في “نظرية فيثاغورس المعممة (Generalized Pythagorean Theorem)”.
في الفضاء الإقليدي، عندما تشكل 3 نقاط $P, Q, R$ مثلثاً قائم الزاوية حيث $\angle PQR = 90^\circ$، فإن $d(P, R)^2 = d(P, Q)^2 + d(Q, R)^2$ تتحقق. في الفضاء المسطح المزدوج في هندسة المعلومات، عندما يتكون المنحنى الذي يربط النقاط $P, Q, R$ (التوزيعات الاحتمالية) من جيوديسية e وجيوديسية m، وتكون “متعامدة” بمعنى مقياس فيشر عند النقطة $Q$، فإن المعادلة التالية تتحقق بدقة فيما يتعلق بالتباعد (مفهوم المسافة غير المتماثلة) بين التوزيعات.
$$ D(P \parallel R) = D(P \parallel Q) + D(Q \parallel R) $$هذه النظرية تشرح بشكل هندسي كامل معايير كمية المعلومات في الإحصاء، وتقارب خوارزمية EM في التعلم الآلي، ونظرية الإسقاط (Information Projection)، وهي نتيجة يمكن اعتبارها من أعظم إنجازات هندسة المعلومات.
الفصل الرابع: هندسة التباعد والإنتروبيا
المسافة في الهندسة الريمانية متماثلة ($d(x, y) = d(y, x)$)، ولكن مقياس “الاختلاف” بين التوزيعات الاحتمالية في نظرية المعلومات يكون بشكل عام غير متماثل. تربط هندسة المعلومات ببراعة بين هذه المسافة غير المتماثلة “التباعد (Divergence)” والبنية الهندسية للفضاء المسطح المزدوج.
معلومات كولباك-لايبْلَر (تباعد KL)
$$ D_{KL}(P \parallel Q) = \int p(x) \log \frac{p(x)}{q(x)} dx $$لا يفي تباعد KL ببديهيات المسافة (فهو غير متماثل ولا يحقق متباينة المثلث). ولكن، في النهاية (الحد) حيث تقترب النقطة $Q$ إلى ما لا نهاية من النقطة $P$، فإن الحد من الدرجة الثانية في متسلسلة تايلور لتباعد KL يتطابق تماماً مع مصفوفة معلومات فيشر.
$$ D_{KL}(\theta \parallel \theta + d\theta) \approx \frac{1}{2} \sum_{i,j} g_{ij}(\theta) d\theta^i d\theta^j $$بمعنى آخر، تباعد KL هو مسافة ماكرو (كبرية) غير متماثلة، ونهايتها الميكروية (الدقيقة) (المسافة المتناهية الصغر) هي التي تحفز مقياس فيشر (الهندسة الريمانية).
تباعد بريغمان وتحويل ليجاندر
في الفضاء المسطح المزدوج، تتم صياغة التباعد بشكل أكثر عمومية كـ “تباعد بريغمان (Bregman Divergence)”. لنعتبر دالة محدبة $\psi(\theta)$ (تقابل الدالة المولدة للمتراكمات أو الطاقة الحرة). يُعرَّف تباعد بريغمان $D_\psi(\theta_P \parallel \theta_Q)$ على أنه “الخطأ” بين المستوى المماس للدالة المحدبة عند النقطة $\theta_Q$ وقيمة الدالة المحدبة عند النقطة $\theta_P$.
$$ D_\psi(\theta_P \parallel \theta_Q) = \psi(\theta_P) - \psi(\theta_Q) - \sum_i (\theta_P^i - \theta_Q^i) \frac{\partial \psi(\theta_Q)}{\partial \theta^i} $$$$ \eta_i = \frac{\partial \psi(\theta)}{\partial \theta^i}, \quad \phi(\eta) = \sum_i \theta^i \eta_i - \psi(\theta) $$في هندسة المعلومات، تباعد KL هو بحد ذاته تباعد بريغمان على عائلة التوزيعات الأسية، وباستخدام المعلمات المزدوجة $\theta$ (المعلمات الطبيعية) و $\eta$ (معلمات القيمة المتوقعة)، يمكن التعبير عن التباعد في شكل قانوني (Canonical form) متماثل وجميل للغاية باستخدام الدوال المزدوجة $\psi, \phi$.
$$ D(P \parallel Q) = \psi(\theta_P) + \phi(\eta_Q) - \sum_i \theta_P^i \eta_Q^i $$تحكي هذه المعادلة بوضوح أن هندسة المعلومات ليست مجرد تطبيق للهندسة التفاضلية، بل هي “هندسة خاصة بنظرية المعلومات” مرتبطة ارتباطاً وثيقاً بتحويل ليجاندر والتحليل المحدب.
الفصل الخامس: التعلم العميق وطريقة الانحدار الطبيعي
لا تقتصر هندسة المعلومات على الجمال النظري، بل تُظهر قوة عملية فائقة في الذكاء الاصطناعي الحديث، وخاصة في التعلم العميق (Deep Learning). وأفضل مثال على ذلك هو “طريقة الانحدار الطبيعي (Natural Gradient Descent; NGD)”.
قيود طريقة الانحدار العادية
$$ w_{t+1} = w_t - \eta \nabla L(w_t) $$ومع ذلك، يفترض الانحدار العادي $\nabla L$ أن فضاء المعلمات هو “فضاء إقليدي مسطح”. كما رأينا في الفصل الأول، فضاء المعلمات للنموذج الاحتمالي الذي تمثله الشبكة العصبية هو متعدد طيات ريماني منحنٍ بفعل مقياس فيشر. انحدار الفضاء الإقليدي (اتجاه النزول الأشد) لا يتطابق مع اتجاه النزول الأشد الحقيقي على متعدد الطيات الريماني. لذلك، بناءً على مقياس المعلمات أو تحويل الإحداثيات، يتغير مسار التعلم بشكل كبير، مما يؤدي بكثرة إلى حدوث ظاهرة “الهضبة (Plateau، ركود التعلم)” حيث تنخفض كفاءة التحسين بشكل ملحوظ.
تحديث المعلمات باستخدام مقياس فيشر: طريقة الانحدار الطبيعي
في عام 1998، اقترح شونيتشي أماري “الانحدار الطبيعي (Natural Gradient)” وهو الاتجاه الحقيقي للنزول الأشد على متعدد الطيات الريماني. الانحدار $\tilde{\nabla} L$ على متعدد الطيات هو الانحدار العادي $\nabla L$ مضروباً في المعكوس لمصفوفة معلومات فيشر $F^{-1}$.
$$ \tilde{\nabla} L(w) = F(w)^{-1} \nabla L(w) $$$$ w_{t+1} = w_t - \eta F(w_t)^{-1} \nabla L(w_t) $$من خلال أخذ انحناء فضاء المعلمات (مصفوفة معلومات فيشر) في الاعتبار، تحقق طريقة الانحدار الطبيعي تعلماً ثابتاً لا يعتمد على كيفية اختيار المعلمات (نظام الإحداثيات). نتيجة لذلك، حتى لو كانت خطوط الكنتور لدالة الخسارة عبارة عن تضاريس مثل قاع وادٍ مشوه، فمن الممكن التوجه بشكل مستقيم نحو الحل الأمثل، مما يحسن سرعة التعلم بشكل هائل. يشبه هذا طرق التحسين من الدرجة الثانية مثل طريقة نيوتن، ولكنه طريقة محسنة للنماذج الاحتمالية من حيث أنه يستخدم مصفوفة معلومات فيشر التي تضمن شبه إيجابية محددة بدلاً من مصفوفة هيسيان.
التنفيذ الحسابي التقريبي باستخدام K-FAC والاختراق
على الرغم من القوة النظرية لطريقة الانحدار الطبيعي، إلا أن هناك عقبة كبيرة أمام تطبيقها في التعلم العميق. في الشبكات العصبية الحديثة التي تمتلك عشرات الملايين إلى عشرات المليارات من المعلمات، حساب مصفوفة معلومات فيشر الضخمة $F$ (بحجم $N \times N$) وإيجاد معكوسها كان أمراً ميؤوساً منه من وجهة نظر التعقيد الحسابي ($O(N^3)$).
الذي حل هذه المشكلة هو طريقة تسمى K-FAC (Kronecker-factored Approximate Curvature) والتي اقترحها جيمس مارتينز (James Martens) وروجر غروس (Roger Grosse) وآخرون في عام 2015. لقد أوضحوا أنه يمكن تقريب مصفوفة معلومات فيشر للمعلمات بين طبقات الشبكة العصبية بدقة عالية عن طريق “جداء كرونيكر (Kronecker Product)” لمصفوفة التغاير للمدخلات ومصفوفة التغاير لانحدار المخرجات.
$$ F_{layer} \approx A \otimes S $$(هنا $A$ هي تغاير قيم التنشيط، و $S$ هي تغاير انحدار التنشيط المسبق)
باستخدام خاصية جداء كرونيكر $(A \otimes S)^{-1} = A^{-1} \otimes S^{-1}$، يمكن تحليل حساب معكوس مصفوفة ضخمة إلى حساب معكوس مصفوفات أصغر بكثير، ونجحوا في تقليل التكلفة الحسابية بشكل جذري (من $O(N^3)$ إلى $O(n^3)$، حيث $n$ هو عرض الطبقة). مع تنفيذ K-FAC، أصبحت طريقة الانحدار الطبيعي قابلة للتطبيق على نماذج التعلم العميق واسعة النطاق (مثل ResNet و Transformer) في وقت حساب واقعي، وقد ثبت أنها تُظهر تقارباً سريعاً للغاية في بيئات التعلم الموزع. كانت هذه لحظة تاريخية اخترقت فيها هندسة المعلومات حدود الذكاء الاصطناعي.
الفصل السادس: الامتداد إلى الفيزياء الإحصائية، والمعلومات الكمومية، وعلم الأعصاب
لا تقتصر عمومية هندسة المعلومات على الإحصاء والتعلم الآلي. “هندسة الاحتمالات والمعلومات” الكامنة في جذورها تمتد إلى العديد من المجالات العلمية.
هندسة المعلومات الكمومية
هندسة المعلومات التي تتعامل مع التوزيعات الاحتمالية الكلاسيكية تمتد بشكل طبيعي إلى هندسة المعلومات الكمومية (Quantum Information Geometry) التي تتعامل مع “مصفوفة الكثافة (Density Matrix)” في ميكانيكا الكم. في الأنظمة الكمومية، وبسبب عدم تبادلية المتغيرات القابلة للرصد (تغير النتيجة بناءً على ترتيب المؤثرات)، لا يتم تحديد ما يعادل مقياس فيشر بشكل فريد. بدلاً من ذلك، هناك مقاييس ريمانية متعددة مثل مقياس بوريس (Bures Metric / كمية معلومات فيشر SLD) ومقياس كوبو-موري-بوغوليوبوف (Kubo-Mori-Bogoliubov Metric)، ولكل منها معنى فيزيائي ومعلوماتي مختلف. تتطور هندسة المعلومات الكمومية بسرعة كأساس نظري لأجهزة الكمبيوتر الكمومية والاتصالات الكمومية، مثل حدود دقة تقدير الحالة الكمومية (متباينة كرامير-راو الكمومية)، والتوضيح الهندسي للتشابك الكمومي (Entanglement)، وتحسين الخوارزميات الكمومية.
مبدأ الطاقة الحرة وعلم الأعصاب (التشفير التنبؤي)
في مجال علم الأعصاب، يفترض مبدأ الطاقة الحرة (Free Energy Principle; FEP) الذي اقترحه كارل فريستون (Karl Friston) أن الدماغ هو نظام يستنتج الإدراك والسلوك لتقليل “المفاجأة (Surprise)”. تتم صياغة عملية الاستدلال هذه على أنها استدلال بايزي متغير (Variational Bayesian Inference)، وهناك تنتهي إلى مشكلة تحسين تقلل من تباعد KL (الطاقة الحرة المتغيرة) بين التوزيع الاحتمالي للنموذج الداخلي في الدماغ والتوزيع الحقيقي للبيئة الخارجية.
من منظور هندسة المعلومات، يمكن تفسير الدماغ على أنه نظام ديناميكي يتحرك على متعدد طيات للتوزيعات الاحتمالية، متبعاً انحدار التباعد (أي الانحدار الطبيعي). الإدراك (تحديث الحالة الداخلية) والسلوك (التأثير على البيئة الخارجية) يوصفان بشكل جميل كخوارزمية تكرارية للإسقاط e والإسقاط m في الفضاء المسطح المزدوج. توفر هندسة المعلومات لغة رياضية لفك شفرة الآليات الأساسية للذكاء.
كجبهة رائدة للرياضيات الحديثة
حتى من وجهة نظر الرياضيات البحتة، قدمت هندسة المعلومات نموذجاً فكرياً جديداً (Paradigm). يتم الكشف عن الروابط العميقة مع الهندسة التفاضلية التآلفية، وهندسة هيسيان، والهندسة السمبلكتية. بشكل خاص، يعد دمج هندسة واسرشتاين (Wasserstein Geometry - نظرية النقل الأمثل) وهندسة المعلومات أحد أهم موضوعات البحث الحالية في الرياضيات والتعلم الآلي. في حين يقيس تباعد KL (هندسة المعلومات) حركة “المعلومات”، تقيس مسافة واسرشتاين حركة “الكتلة”. ترتبط محاولة دمج هاتين الهندستين مباشرة بالتوضيح النظري للنماذج التوليدية العميقة (نماذج الانتشار وشبكات الخصومة التوليدية GAN).
الخاتمة: شكل الكون الذي تنسجه المعلومات
هندسة المعلومات، التي وُلدت من حدس شونيتشي أماري القائل بأن “النماذج الإحصائية قد تكون منحنية”، تجاوزت الآن إطار علم الإحصاء، ونمت لتصبح نظاماً نظرياً كبيراً يربط بين التعلم الآلي، والفيزياء الكمومية، وعلم الأعصاب. من خلال التعامل مع التوزيع الاحتمالي ليس فقط كدالة، بل كـ “فضاء” هندسي، يمكننا فهم حركة المعلومات بصرياً، ومسار التعلم، وجوهر الذكاء.
“درجة انحناء المعلومات” التي يعلمنا إياها مقياس معلومات فيشر. “نظرية فيثاغورس المعممة” التي تقودنا إليها الروابط المزدوجة. و"التطور السريع للذكاء الاصطناعي” الذي تفتح آفاقه طريقة الانحدار الطبيعي.
ستظل هندسة المعلومات “البوصلة” الأكثر تعقيداً ودقة بالنسبة لنا لإيجاد كوكبة من الحقائق وسط نجوم البيانات. إن استكشاف هذا المتعدد الطيات الريماني الجميل والعميق في نفس الوقت، قد بدأ للتو.