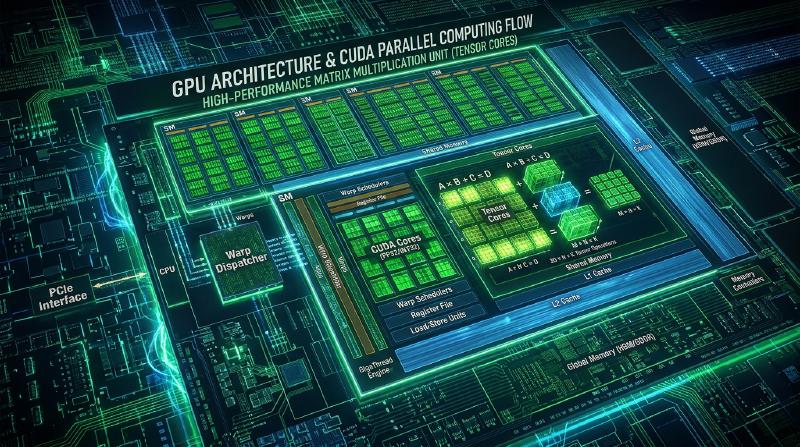
بنية وحدة معالجة الرسومات فائقة التوازي وفيزياء CUDA: مبادئ حساب SIMT، Warp، و Tensor Core
التقنية الأساسية التي تدعم العلوم الحسابية المتقدمة الحديثة، والذكاء الاصطناعي، والتعلم العميق، ورسومات الكمبيوتر عالية الدقة هي وحدة معالجة الرسومات (GPU). في هذا المقال، سنتعمق في الجوانب المادية والأجهزة لبنية وحدة معالجة الرسومات ومنصة الحوسبة المتوازية CUDA (Compute Unified Device Architecture) التي تعمل عليها. بدلاً من مجرد قواعد البرمجة، سنقوم بتحليل دقيق لـ “لماذا تم تصميم الأجهزة بهذه الطريقة” و “كيف تحقق إنتاجية حسابية قصوى” من منظور المعالجات المتعددة المتدفقة (SM)، ونموذج تنفيذ SIMT، وجدولة Warp، ونوى Tensor، وتسلسل الذاكرة.
الفصل 1: نقطة التفرع في فلسفات تصميم وحدة المعالجة المركزية (CPU) ووحدة معالجة الرسومات (GPU)
1.1 السعي وراء زمن انتقال منخفض مقابل السعي وراء إنتاجية عالية
تختلف فلسفة التصميم بشكل أساسي بين المعالجات العامة، وهي وحدات المعالجة المركزية (CPU)، ووحدات معالجة الرسومات (GPU) المخصصة للحوسبة المتوازية، وذلك بسبب خلفيات تطويرها. تطورت وحدات المعالجة المركزية ليكون هدفها الأسمى “تقليل زمن الانتقال (Latency)"، أي “مدى سرعة إنجاز مهمة واحدة (خيط)”. من ناحية أخرى، تسعى وحدات معالجة الرسومات إلى “الإنتاجية العالية (Throughput)"، أي “تجميع كميات هائلة من المهام، ومقدار المعالجة التي يمكن إكمالها في وحدة زمنية بشكل عام”.
تحتاج وحدات المعالجة المركزية إلى التعامل بسرعة مع المهام غير المتوقعة مثل التحكم في نظام التشغيل، وتنفيذ التطبيقات ذات شروط التفرع المعقدة، ومعالجة المقاطعات العشوائية من المستخدم. لذلك، فهي مجهزة بدوائر تنبؤ فرعية متقدمة، وتنفيذ خارج الترتيب (Out-of-order execution)، وذواكر تخزين مؤقت ضخمة (L1/L2/L3)، مما يزيد من أداء خيط واحد إلى الحد الأقصى مع إخفاء تأخير الوصول إلى الذاكرة.
في المقابل، تم إنشاء وحدات معالجة الرسومات في الأصل لمعالجة المهام القابلة للتوازي بشكل كبير، مثل تطبيق نفس حسابات التظليل على ملايين وحدات البكسل على الشاشة. بدلاً من تخصيص مساحة الشريحة لدوائر التحكم المعقدة وذواكر التخزين المؤقت الضخمة، اختاروا تعبئة أكبر عدد ممكن من وحدات الحساب المنطقية البسيطة (ALU).
1.2 نسبة تخصيص ذاكرة التخزين المؤقت، دوائر التحكم، و ALU في مساحة الشريحة
كيفية تخصيص المساحة المحدودة (ميزانية الترانزستور) لشريحة السيليكون تحدد الاختلاف المعماري بين الاثنين.
- تخصيص مساحة شريحة وحدة المعالجة المركزية: يشغل أكثر من نصف الشريحة ذواكر تخزين مؤقت كبيرة السعة (SRAM) ودوائر تحكم متقدمة (تنبؤ التفرع، جلب التعليمات، فك التشفير، الجدولة، إلخ). نسبة الـ ALU التي تقوم بالحسابات الفعلية صغيرة نسبيًا.
- تخصيص مساحة شريحة وحدة معالجة الرسومات: يتم تقليل ذواكر التخزين المؤقت ودوائر التحكم إلى الحد الأدنى الضروري، وتشغل الآلاف إلى عشرات الآلاف من ALU (نوى CUDA) معظم الشريحة.
لا تخفي وحدات معالجة الرسومات تأخير الوصول إلى الذاكرة (زمن الانتقال) باستخدام ذاكرة التخزين المؤقت، بل تخفيه عن طريق “تبديل السياق (Context Switching)”. أثناء انتظار مجموعة من الخيوط لوصول البيانات من الذاكرة، يتم تنفيذ عمليات حسابية لمجموعة أخرى من الخيوط على الفور، مما يحافظ على وحدات الحساب قيد التشغيل دائمًا (نسبة إشغال عالية: Occupancy). هذا هو التنفيذ المادي لـ “السعي وراء إنتاجية عالية” في وحدات معالجة الرسومات. نظرًا لأن تعدد مؤشرات الترابط على مستوى الأجهزة (Hardware Multithreading) يتم بخفة شديدة، يُفترض وجود الآلاف إلى عشرات الآلاف من الخيوط المتوازية.
الفصل 2: جوهر نموذج تنفيذ SIMT
2.1 الفرق بين SIMD و SIMT
على الرغم من وجود تصنيف Flynn للمعالجة المتوازية، إلا أن نموذج تنفيذ وحدة معالجة الرسومات غالبًا ما يُقارن بـ SIMD (تعليمات مفردة، بيانات متعددة). تعليمات المتجهات الموسعة في وحدات المعالجة المركزية (مثل AVX) هي SIMD بحت، حيث تعالج تعليمة واحدة بيانات متعددة (مثلاً، 8 أرقام فاصلة عائمة بحجم 32 بت مخزنة في سجل بعرض 256 بت) في نفس الوقت. في SIMD، من الصعب جدًا إجراء تفرعات مختلفة (if-else) لكل عنصر من عناصر البيانات.
من ناحية أخرى، يُطلق على نموذج تنفيذ CUDA الذي اقترحته NVIDIA اسم SIMT (تعليمة مفردة، خيوط متعددة). في SIMT، تشكل “خيوط” متعددة مستقلة مجموعة (تُعرف باسم “Warp” لاحقًا) وتتشارك نفس التعليمة وتنفذها. ومع ذلك، على عكس SIMD، يحتوي كل خيط في SIMT على حالة سجل مستقلة وعداد عنوان تعليمة (على نموذج البرمجة). يتيح ذلك للمبرمج كتابة التعليمات البرمجية كما لو كان كل خيط يعمل بشكل مستقل.
2.2 “Warp” كوحدة من 32 خيطًا
لا تجدول أجهزة وحدة معالجة الرسومات الخيوط بشكل فردي، بل تديرها وتنفذها في وحدة تسمى “Warp” تجمع 32 خيطًا معًا. (في وحدات معالجة الرسومات من AMD، يُطلق عليها اسم Wavefront، وقد يتم استخدام وحدات من 64 خيطًا).
تقوم وحدة جلب وفك تشفير التعليمات داخل المعالج المتعدد المتدفق (SM) بجلب تعليمة واحدة لكل وحدة Warp، وإصدار (إرسال) نفس التعليمة إلى جميع الخيوط الـ 32 داخل Warp. بمعنى آخر، تنفذ الخيوط الـ 32 داخل Warp فعليًا نفس التعليمة، كل منها على بيانات مختلفة، في نفس الوقت تمامًا. هذا هو جوهر SIMT.
2.3 العقوبة المادية لتباين Warp (Warp Divergence)
على الرغم من أن كل خيط يمكن أن يتصرف كما لو كان لديه عداد برنامج مستقل، يجب ماديًا على جميع الخيوط في Warp تنفيذ نفس التعليمة. ماذا يحدث إذا كان هناك تفرع شرطي مثل if-else في الكود، واختلفت نتيجة التفرع (صح أو خطأ) بين الخيوط في Warp؟
تسمى هذه الظاهرة تباين Warp (Warp Divergence).
عند حدوث تباين Warp، تقوم الأجهزة بمعالجته في الخطوات التالية:
- أولاً، تنفذ التعليمة فقط للخيوط التي يكون فيها شرط
ifصحيحًا (الخيوط النشطة). في هذا الوقت، يتم “إخفاء (Mask)” الخيوط التي يكون فيها الشرط خاطئًا، ولا يتم كتابة نتيجة العملية الحسابية. - بعد ذلك، ينتقل التنفيذ إلى مسار
else(أو المسار عندما يكون الشرط خاطئًا)، ويقوم هذه المرة بتنشيط الخيوط التي كانت مخفية سابقًا، وإخفاء الخيوط التي كانت صحيحة، وينفذ التعليمة.
بمعنى آخر، إذا كان هناك مسارات تفرع متعددة، تُجبر الأجهزة على تنفيذ هذه المسارات بشكل تسلسلي بدلاً من متوازي. كمثال متطرف، إذا سلكت 32 خيطًا في Warp 32 مسار تفرع مختلفًا، سيزيد وقت التنفيذ 32 مرة. يُعد تباين Warp أحد أكبر أسباب الانخفاض الحاد في إنتاجية الحساب في وحدات معالجة الرسومات، وهو نمط مضاد (Anti-pattern) يجب تجنبه بأي ثمن في تصميم الخوارزميات. ماديًا، هذا يعني حدوث “دورات ضائعة” حيث تستهلك وحدة ALU الطاقة، لكنها لا تنتج نتائج حسابية صالحة لأنها مخفية.
الفصل 3: تشريح أجهزة المعالج المتعدد المتدفق (SM)
تتكون وحدة معالجة الرسومات من مجموعة من المعالجات المتعددة المتدفقة (SM: Streaming Multiprocessors). SM هو محرك الحساب الحقيقي لوحدة معالجة الرسومات. في البنى الحديثة (مثل Hopper H100)، تحتوي شريحة وحدة معالجة الرسومات الواحدة على أكثر من 100 SM.
3.1 هيكل خط الأنابيب داخل SM
ينقسم SM داخليًا إلى أقسام فرعية متعددة (عادةً 4)، لكل منها مجدول Warp ووحدة إرسال مستقلة.
- مجدول Warp (Warp Scheduler): يختار Warp الموجود في حالة قابلة للتنفيذ (حالة تكون فيها السجلات والذاكرة جاهزة). يمكن لمجدول وحدة معالجة الرسومات تبديل Warps دون أي حمل إضافي (Zero-overhead)، وهذا هو المفتاح لإخفاء زمن انتقال الوصول إلى الذاكرة.
- وحدة الإرسال (Dispatch Unit): تصدر التعليمات للـ Warp المجدول.
- نوى CUDA (INT32 / FP32 / FP64 ALU): وحدات تقوم بإجراء العمليات الحسابية للأعداد الصحيحة وعمليات الفاصلة العائمة.
- وحدة التحميل/التخزين (LD/ST Unit): مسؤولة عن القراءة والكتابة في الذاكرة.
- وحدة الوظائف الخاصة (SFU): جهاز مخصص لحساب الوظائف المتسامية مثل الجيب، جيب التمام، الأُس، والمقلوب بسرعة.
تم تصميم خط أنابيب التعليمات ليكون عميقًا للغاية، ويحتوي على مراحل للجلب، وفك التشفير، والجدولة، وقراءة السجلات، والتنفيذ (دورات متعددة)، والكتابة مرة أخرى. عادةً ما يستغرق زمن انتقال عملية FP32 FMA (الضرب والجمع المدمج) من عدة دورات إلى أكثر من عشر دورات، ولكن عن طريق إصدار تعليمات من Warps مختلفة في كل دورة، يظل خط الأنابيب ممتلئًا دائمًا.
3.2 ملفات السجلات الضخمة وضغط السجلات
يحتوي SM على ملفات سجلات (Register Files) هائلة لا يمكن مقارنتها بوحدات المعالجة المركزية (مثلاً: 64 كيلو بايت إلى 256 كيلو بايت من SRAM لكل SM). وذلك للحفاظ على سياقات آلاف الخيوط التي تعمل بشكل متزامن على SM.
يكتمل تبديل السياق في دورة الصفر لأنه ليس من الضروري حفظ حالة سجل الخيط في الذاكرة (Spill). ومع ذلك، مع زيادة عدد السجلات المستخدمة لكل خيط، ينخفض عدد Warps التي يمكن تنشيطها في نفس الوقت في SM (الاشغال). وهذا ما يسمى ضغط السجلات (Register Pressure). عند نفاد السجلات، يتم تسريب البيانات إلى ذاكرة محلية أبطأ (ماديًا جزء من الذاكرة العامة)، مما يتسبب في انخفاض كارثي في الأداء.
3.3 الذاكرة المشتركة (Shared Memory) وتعارض البنوك
يوجد في SM ذاكرة سريعة جدًا على الرقاقة تسمى الذاكرة المشتركة (Shared Memory)، والتي يمكن برمجتها والتحكم فيها بشكل صريح. على الرغم من أنها تشارك نفس منطقة SRAM الفعلية مثل ذاكرة التخزين المؤقت L1، إلا أنها تعمل كذاكرة تخزين مؤقت للبيانات الصريحة، وتُستخدم لمشاركة البيانات والمزامنة بين الخيوط داخل الكتلة.
ينقسم الهيكل المادي للذاكرة المشتركة إلى وحدات مستقلة متعددة (عادةً 32) تسمى بنوك الذاكرة (Memory Banks). يتم تداخل (تعيين) العناوين المتتالية بحجم 32 بت إلى بنوك مختلفة.
عندما تصل الـ 32 خيطًا في Warp إلى بنوك مختلفة في نفس الوقت، تتم معالجة الوصول بشكل متوازٍ تمامًا (في دورة واحدة). هذا ما يسمى “خالي من تعارض البنوك (Bank Conflict Free)”. ومع ذلك، إذا حاولت خيوط متعددة الوصول إلى عناوين مختلفة في نفس البنك في نفس الوقت، يتم تسلسل الطلبات وتحدث عقوبة (تأخير). وهذا ما يسمى تعارض البنك (Bank Conflict). على سبيل المثال، في تعارض بنك ثنائي الاتجاه، يتضاعف وقت الوصول، وفي أسوأ الحالات مع تعارض 32 اتجاهًا، يتأخر بمقدار 32 مرة. في الخوارزميات مثل تبديل المصفوفات (Matrix Transpose)، تحدث تعارضات بنكية خطيرة بسبب الوصول المتخطي (Stride Access)، لذا فإن التحسينات المتقدمة باستخدام “الحشو (Padding)” (إدراج بيانات وهمية لتغيير عناوين الذاكرة) ضرورية لتجنب التعارض.
الفصل 4: خط أنابيب عمليات الضرب والجمع في نوى Tensor (Tensor Core)
إن نوى Tensor (Tensor Core) هي أجهزة ثورية تم تقديمها لأول مرة في بنية Volta ودفعت أداء وحدات معالجة الرسومات اللاحقة بشكل كبير. لا يمكن الحديث عن التطور الهائل للذكاء الاصطناعي والتعلم العميق بدون نوى Tensor.
4.1 التنفيذ المادي لعمليات ضرب وجمع المصفوفات (MMA)
معظم الحسابات في التعلم العميق هي ضرب المصفوفات (GEMM: General Matrix Multiply) لمصفوفات الأوزان للشبكات العصبية وبيانات الإدخال. يُعبر عن هذا بالمعادلة $D = A \times B + C$ (حيث $A, B$ هما مصفوفات الإدخال، و $C$ مصفوفة المجمع).
في نوى CUDA التقليدية، يتم حساب ضرب المصفوفات هذا عنصرًا بعنصر باستخدام تعليمات FMA (الضرب والجمع المدمج). في المقابل، فإن نوى Tensor هي دوائر مخصصة تنفذ عمليات الضرب والجمع لمصفوفات صغيرة (مثل 4x4 أو 16x16) على مستوى الأجهزة في دورة واحدة (أو دورات قليلة).
ماديًا، يتم توصيل عشرات إلى مئات من وحدات الضرب وشجرة جمع ضخمة مباشرة بالأسلاك، ويتم إكمال عمليات الضرب والجمع دفعة واحدة دون كتابة النتائج الوسيطة مرة أخرى إلى السجلات. بفضل هذا، فإن إنتاجية الحساب (TFLOPS) لكل مساحة تكون أعلى بكثير مقارنة بنوى CUDA العادية.
4.2 سر الدقة المختلطة (Mixed-Precision)
ميزة أخرى مهمة في نوى Tensor هي دعم عمليات الدقة المختلطة (Mixed-Precision). في التعلم العميق، غالبًا لا تكون هناك حاجة إلى دقة عالية (FP32/FP64) أثناء الحساب. تحتوي نوى Tensor على خط أنابيب يقرأ مصفوفات الإدخال $A$ و $B$ بدقة منخفضة (FP16، BF16، أو حتى FP8، INT8، INT4)، ويجري عمليات الضرب الداخلية بدقة منخفضة، ثم يجري عملية الجمع (التراكم) بدقة أعلى (FP32 أو INT32).
- FP16 / BF16: المعيار للتدريب. يحتوي BF16 (Bfloat16) على جزء أسي بحجم 8 بت مثل FP32، ونطاق ديناميكي واسع، مما يسهل منع تلاشي التدرج.
- FP8 / INT8 / INT4: الورقة الرابحة لتسريع الاستدلال (Inference). نظرًا لتقليل كمية نقل البيانات (نطاق الذاكرة الترددي)، تتحسن الإنتاجية بشكل كبير.
في بنية Hopper، تم تقديم “FP8 Tensor Core” الذي يسرّع بشكل كبير حسابات نموذج Transformer، محققًا إنتاجية نظريًا عشرات المرات أعلى مقارنة بـ FP32. من جانب البرنامج (CUDA)، من خلال واجهة برمجة تطبيقات wmma (ضرب وتراكم المصفوفات على مستوى Warp) أو تعليمة mma.sync PTX، يتم تشغيل نوى Tensor مباشرة، حيث تتعاون الخيوط داخل Warp لتحميل أجزاء المصفوفة إلى السجلات، وحسابها، وتخزينها، في عملية جماعية معقدة للغاية.
الفصل 5: تسلسل ذاكرة CUDA وتقنيات التحسين
بغض النظر عن مدى ارتفاع قدرة وحدة معالجة الرسومات الحسابية، إذا أصبح إمداد البيانات عنق الزجاجة، فلن يتم تحقيق الأداء (مشكلة جدار الذاكرة). ليس من المبالغة القول إن 90٪ من التحسين في برمجة CUDA هو “تحسين الوصول إلى الذاكرة”.
5.1 الوصول المدمج للذاكرة العامة (Coalescing)
تتمتع الذاكرة العامة (Global Memory)، وهي الذاكرة الرئيسية لوحدة معالجة الرسومات (HBM أو GDDR)، بنطاق ترددي واسع جدًا (مثلاً، عدة تيرابايت/ثانية)، ولكن زمن انتقالها كبير جدًا (مئات الدورات).
المبدأ المطلق لزيادة كفاءة الوصول إلى الذاكرة العامة إلى أقصى حد هو الدمج (Coalescing). يقوم متحكم الذاكرة في وحدة معالجة الرسومات بالوصول إلى الذاكرة في معاملات بحجم 32 بايت، 64 بايت، أو 128 بايت. عندما تصل 32 خيطًا في Warp إلى الذاكرة، وإذا كانت عناوين الذاكرة الخاصة بها تقع ضمن منطقة متتالية (داخل حدود 128 بايت محاذاة)، تقوم الأجهزة بدمج هذه الطلبات في معاملة ذاكرة واحدة ومعالجتها.
على العكس من ذلك، إذا وصلت الخيوط إلى عناوين عشوائية، أو أجرت وصولًا متخطيًا (متباعدًا)، فلن يحدث الدمج، وستنشأ معاملات متعددة. يُطلق على هذا “الوصول غير المدمج”، وهو خطأ في الأداء (Performance Bug) قاتل يقلل النطاق الترددي الفعال للذاكرة إلى عُشر أو أقل.
5.2 مثال كود CUDA C++: تحسين تبديل المصفوفة والذاكرة المشتركة
فيما يلي مثال على كود نواة محسّن لتبديل المصفوفات (Matrix Transpose) يتجنب الوصول غير المدمج ويستفيد من الذاكرة المشتركة لتحسين الأداء بشكل كبير.
| |
النقاط الرئيسية لهذا الكود هي ثلاث:
- الدمج عند القراءة: نظرًا لأن القراءة من
idataتتم في اتجاه X حيث تكونthreadIdx.xمتتالية، يتم الدمج تمامًا. - الدمج عند الكتابة: تم تصميم الكتابة في
odataأيضًا لتكون متتالية في اتجاهthreadIdx.xعن طريق تبديل إحداثيات الكتلة، مما يحقق الدمج. - الحشو في الذاكرة المشتركة: من خلال تغيير العنصر بمقدار 1 مع
tile[TILE_DIM][TILE_DIM + 1](الحشو)، يتم التخلص تمامًا من تعارض البنوك عند الوصول في اتجاه العمود (tile[threadIdx.x][threadIdx.y + j]) أثناء الكتابة.
5.3 تسلسل التخزين المؤقت والذواكر الخاصة
- سياسة ذاكرة التخزين المؤقت L1/L2: في بنيات وحدات معالجة الرسومات الحديثة، يمكن للمبرمجين التحكم في سلوك ذاكرة التخزين المؤقت كإشارات باستخدام تعليمات PTX (مثل
.ca،.cg،.cs). على سبيل المثال، يمكن للبيانات التي يتم الوصول إليها مرة واحدة فقط تجاوز ذاكرة التخزين المؤقت L2 (وصول متدفق) لمنع تلوث ذاكرة التخزين المؤقت. - ذاكرة النسيج (Texture Memory) / الذاكرة الثابتة (Constant Memory): تستفيد ذاكرة النسيج، المتخصصة في معالجة الصور، من ذاكرات تخزين مؤقت مخصصة للوصول إلى المكانية ثنائية الأبعاد. تفتخر الذاكرة الثابتة بكفاءة عالية للغاية للوصول بالبث، حيث تقرأ جميع الخيوط نفس الثابت.
الفصل 6: مستقبل وحدات معالجة الرسومات في عصر التعلم العميق
لا تقتصر جبهة العلوم الحسابية الحالية على تحسين أداء وحدات معالجة الرسومات الفردية فحسب، بل تمتد لتشمل التوسع على مستوى النظام بأكمله.
6.1 التوصيل البيني فائق السرعة عبر NVLink و NVSwitch
لا يمكن لنماذج اللغة الكبيرة (LLMs) الضخمة أن تتسع في ذاكرة وحدة معالجة رسومات واحدة (مثلاً 80 جيجابايت أو 144 جيجابايت). لإجراء موازاة للنماذج (التوازي الشدني أو توازي خطوط الأنابيب)، يجب تبادل البيانات بمستوى تيرابايت في الثانية بين وحدات معالجة الرسومات. نظرًا لأن ناقل PCIe التقليدي لا يمكنه تغطية هذا النطاق الترددي، طورت NVIDIA تقنية اتصال داخلي عالي السرعة تسمى NVLink. علاوة على ذلك، باستخدام شريحة محول تسمى NVSwitch، أصبح من الممكن بناء مجموعة (Cluster) تربط 8 أو 256 وحدة معالجة رسومات معًا من خلال محولات تقاطع غير مانعة بالكامل، مما يسمح لها بالعمل كما لو كانت وحدة معالجة رسومات واحدة عملاقة.
6.2 محرك Transformer (Transformer Engine) ونظام FP8 البيئي
للتحسين لـ بنية Transformer، التي أصبحت المعيار الفعلي ليس فقط لمعالجة اللغة الطبيعية ولكن أيضًا للتعرف على الصور والصوت، تم تجهيز بنية Hopper بآلية تعاون للأجهزة والبرامج مخصصة تسمى Transformer Engine. تقوم هذه الآلية بمراقبة المعلومات الإحصائية للموترات ديناميكيًا وتبديل دقة الحساب بين FP8 و FP16 تلقائيًا لكل طبقة (Dynamic Scaling)، مما يمنع تدهور الدقة مع تحقيق سرعات حسابية قصوى وتوفير في النطاق الترددي للذاكرة.
6.3 قوانين التوسع في مجموعات وحدات معالجة الرسومات وآفاق المستقبل
كما توضح “Scaling Laws (قوانين التوسع)” الخاصة بـ OpenAI، كلما زاد عدد معلمات النموذج وحجم العمليات الحسابية، استمر أداء الذكاء الاصطناعي في التحسن. تماشيًا مع هذا، تتطور وحدات معالجة الرسومات من كونها مجرد معالجات إلى أن يصبح “مركز البيانات نفسه عبارة عن وحدة معالجة رسومات واحدة عملاقة (كمبيوتر فائق)” مع عشرات الآلاف من الوحدات المتصلة بالألياف الضوئية.
من المرجح أن يتجه التطور المعماري المستقبلي نحو إدخال الضوئيات السيليكونية (الاتصال البيني البصري)، والبصريات المجمعة المشتركة (CPO)، وزيادة تطور تكنولوجيا التكديس ثلاثي الأبعاد من SRAM إلى HBM. ومع ذلك، فإن الحمض النووي (DNA) الأساسي لوحدة معالجة الرسومات منذ نشأتها، وهو “الوصول بالإنتاجية إلى أقصى حد من خلال المعالجة المتوازية”، سيستمر في ريادة طليعة العلوم الحسابية.
【مقال إضافي】التحليل الرياضي للجدولة والاشغال في وحدات معالجة الرسومات
title: “بنية معالج الرسوميات فائقة التوازي وفيزياء CUDA: مبادئ حساب SIMT، Warp، و Tensor Core” description: “التصميم الداخلي لمعالج الرسوميات الذي يسعى للإنتاجية العالية إلى أقصى حد. جوهر SM، وجدولة Warp، ونواة Tensor، وتحسين الذاكرة المشتركة.” slug: “gpu-architecture-cuda-parallel-computing” date: “2026-10-03T05:00:00+09:00” categories: [“architecture”, “technology”] tags: [“gpu”, “cuda”, “parallel-computing”, “hardware”] image: “eyecatch.jpg”
بنية معالج الرسوميات فائقة التوازي وفيزياء CUDA: مبادئ حساب SIMT، Warp، و Tensor Core
التقنية الأساسية التي تدعم العلوم الحسابية المتقدمة الحديثة، والذكاء الاصطناعي، والتعلم العميق، ورسومات الكمبيوتر عالية الدقة هي معالج الرسوميات (Graphics Processing Unit). في هذا المقال، سنتعمق في الجوانب المادية والأجهزة لبنية معالج الرسوميات ومنصة الحوسبة المتوازية CUDA (Compute Unified Device Architecture) التي تعمل عليها. بدلاً من مجرد قواعد البرمجة، سنقوم بتحليل دقيق لـ “لماذا تم تصميم الأجهزة بهذه الطريقة” و “كيف تحقق إنتاجية حسابية قصوى” من منظور المعالجات المتعددة المتدفقة (SM)، ونموذج تنفيذ SIMT، وجدولة Warp، ونوى Tensor، وتسلسل الذاكرة.
ملحق الفصل 1: نقطة التفرع في فلسفات تصميم المعالجات العامة ومعالجات الرسوميات
1.1 السعي وراء زمن انتقال منخفض مقابل السعي وراء إنتاجية عالية
تختلف فلسفة التصميم بشكل أساسي بين المعالجات العامة (Central Processing Unit)، ومعالجات الرسوميات المخصصة للحوسبة المتوازية، وذلك بسبب خلفيات تطويرها. تطورت المعالجات العامة ليكون هدفها الأسمى “تقليل زمن الانتقال (Latency)"، أي “مدى سرعة إنجاز مهمة واحدة (خيط)”. من ناحية أخرى، تسعى معالجات الرسوميات إلى “الإنتاجية العالية (Throughput)"، أي “تجميع كميات هائلة من المهام، ومقدار المعالجة التي يمكن إكمالها في وحدة زمنية بشكل عام”.
تحتاج المعالجات العامة إلى التعامل بسرعة مع المهام غير المتوقعة مثل التحكم في نظام التشغيل، وتنفيذ التطبيقات ذات شروط التفرع المعقدة، ومعالجة المقاطعات العشوائية من المستخدم. لذلك، فهي مجهزة بدوائر تنبؤ فرعية متقدمة، وتنفيذ خارج الترتيب، وذواكر تخزين مؤقت ضخمة (L1/L2/L3)، مما يزيد من أداء خيط واحد إلى الحد الأقصى مع إخفاء تأخير الوصول إلى الذاكرة.
في المقابل، تم إنشاء معالجات الرسوميات في الأصل لمعالجة المهام القابلة للتوازي بشكل كبير، مثل تطبيق نفس حسابات التظليل على ملايين وحدات البكسل على الشاشة. بدلاً من تخصيص مساحة الشريحة لدوائر التحكم المعقدة وذواكر التخزين المؤقت الضخمة، اختاروا تعبئة أكبر عدد ممكن من وحدات الحساب المنطقية البسيطة (ALU).
1.2 نسبة تخصيص ذاكرة التخزين المؤقت، دوائر التحكم، و ALU في مساحة الشريحة
كيفية تخصيص المساحة المحدودة لشريحة السيليكون تحدد الاختلاف المعماري بين الاثنين.
- تخصيص مساحة شريحة المعالج العام: يشغل أكثر من نصف الشريحة ذواكر تخزين مؤقت كبيرة السعة (SRAM) ودوائر تحكم متقدمة. نسبة الـ ALU التي تقوم بالحسابات الفعلية صغيرة نسبيًا.
- تخصيص مساحة شريحة معالج الرسوميات: يتم تقليل ذواكر التخزين المؤقت ودوائر التحكم إلى الحد الأدنى الضروري، وتشغل الآلاف إلى عشرات الآلاف من ALU (نوى CUDA) معظم الشريحة.
لا تخفي معالجات الرسوميات تأخير الوصول إلى الذاكرة (زمن الانتقال) باستخدام ذاكرة التخزين المؤقت، بل تخفيه عن طريق “تبديل السياق”. أثناء انتظار مجموعة من الخيوط لوصول البيانات من الذاكرة، يتم تنفيذ عمليات حسابية لمجموعة أخرى من الخيوط على الفور، مما يحافظ على وحدات الحساب قيد التشغيل دائمًا (نسبة إشغال عالية). هذا هو التنفيذ المادي لـ “السعي وراء إنتاجية عالية” في معالجات الرسوميات. نظرًا لأن تعدد مؤشرات الترابط على مستوى الأجهزة يتم بخفة شديدة، يُفترض وجود الآلاف إلى عشرات الآلاف من الخيوط المتوازية.
ملحق الفصل 2: جوهر نموذج تنفيذ SIMT
2.1 الفرق بين SIMD و SIMT
كثيرًا ما يقارن نموذج تنفيذ معالج الرسوميات بـ SIMD (تعليمات مفردة، بيانات متعددة). تعليمات المتجهات الموسعة في المعالجات العامة هي SIMD بحت، حيث تعالج تعليمة واحدة بيانات متعددة في نفس الوقت. في SIMD، من الصعب جدًا إجراء تفرعات مختلفة لكل عنصر من عناصر البيانات.
من ناحية أخرى، يُطلق على نموذج تنفيذ CUDA اسم SIMT (تعليمة مفردة، خيوط متعددة). في SIMT، تشكل “خيوط” متعددة مستقلة مجموعة وتتشارك نفس التعليمة وتنفذها. ومع ذلك، يحتوي كل خيط في SIMT على حالة سجل مستقلة وعداد عنوان تعليمة. يتيح ذلك للمبرمج كتابة التعليمات البرمجية كما لو كان كل خيط يعمل بشكل مستقل.
2.2 “Warp” كوحدة من 32 خيطًا
تدير أجهزة معالج الرسوميات الخيوط وتنفذها في وحدة تسمى “Warp” تجمع 32 خيطًا معًا. (في معالجات رسوميات AMD، يُطلق عليها Wavefront، وتكون أحيانًا بـ 64 خيطًا).
تقوم وحدة جلب وفك تشفير التعليمات داخل المعالج المتعدد المتدفق (SM) بجلب تعليمة واحدة لكل وحدة Warp، وإصدار نفس التعليمة إلى جميع الخيوط الـ 32 داخل Warp. تنفذ الخيوط الـ 32 ماديًا نفس التعليمة في نفس الوقت تمامًا، كل منها على بيانات مختلفة. هذا هو جوهر SIMT.
2.3 العقوبة المادية لتباين Warp (Warp Divergence)
على الرغم من أن كل خيط يمكن أن يتصرف كما لو كان لديه عداد برنامج مستقل، يجب ماديًا على جميع الخيوط في Warp تنفيذ نفس التعليمة. إذا كان هناك تفرع شرطي واختلفت النتيجة بين الخيوط في Warp، تسمى هذه الظاهرة تباين Warp.
عند حدوث تباين Warp، تقوم الأجهزة بمعالجته بتنفيذ الخيوط ذات الشرط الصحيح أولاً مع إخفاء الخيوط الأخرى، ثم الانتقال للمسار الآخر وتنفيذ الخيوط الأخرى مع إخفاء الأولى.
هذا يعني أنه يتم تنفيذ مسارات التفرع بشكل تسلسلي بدلاً من متوازي. يُعد تباين Warp أحد أكبر أسباب الانخفاض الحاد في إنتاجية الحساب في معالجات الرسوميات. ماديًا، هذا يعني حدوث “دورات ضائعة” تستهلك فيها وحدات ALU طاقة دون إنتاج نتائج صالحة.
ملحق الفصل 3: تشريح أجهزة المعالج المتعدد المتدفق (SM)
تتكون معالجات الرسوميات من مجموعة من المعالجات المتعددة المتدفقة (SM). SM هو محرك الحساب الحقيقي لمعالج الرسوميات. في البنى الحديثة، تحتوي شريحة معالج الرسوميات الواحدة على أكثر من 100 SM.
3.1 هيكل خط الأنابيب داخل SM
ينقسم SM داخليًا إلى أقسام فرعية متعددة، لكل منها مجدول Warp ووحدة إرسال مستقلة.
- مجدول Warp: يختار Warp الموجود في حالة قابلة للتنفيذ. يمكن لمجدول معالج الرسوميات تبديل Warps دون أي حمل إضافي، مما يخفي زمن انتقال الذاكرة.
- وحدة الإرسال: تصدر التعليمات للـ Warp المجدول.
- نوى CUDA: وحدات تقوم بإجراء العمليات الحسابية للأعداد الصحيحة وعمليات الفاصلة العائمة.
- وحدة التحميل/التخزين: مسؤولة عن القراءة والكتابة في الذاكرة.
- وحدة الوظائف الخاصة (SFU): لحساب الوظائف المتسامية.
تم تصميم خط أنابيب التعليمات ليكون عميقًا للغاية، مما يحافظ على امتلائه دائمًا عبر إصدار تعليمات من Warps مختلفة في كل دورة.
3.2 ملفات السجلات الضخمة وضغط السجلات
يحتوي SM على ملفات سجلات هائلة للحفاظ على سياقات آلاف الخيوط التي تعمل بشكل متزامن. يكتمل تبديل السياق بسرعة لعدم الحاجة لحفظ حالة السجل في الذاكرة. ومع ذلك، زيادة عدد السجلات المستخدمة لكل خيط يقلل عدد Warps التي يمكن تنشيطها (ضغط السجلات). عند نفاد السجلات، يتم تسريب البيانات إلى ذاكرة أبطأ، مما يقلل الأداء.
3.3 الذاكرة المشتركة (Shared Memory) وتعارض البنوك
يوجد في SM الذاكرة المشتركة السريعة جدًا، وتُستخدم لمشاركة البيانات بين الخيوط. ينقسم الهيكل المادي للذاكرة المشتركة إلى وحدات تسمى بنوك الذاكرة.
عند وصول 32 خيطًا في Warp إلى بنوك مختلفة في نفس الوقت، تتم المعالجة في دورة واحدة (خالي من تعارض البنوك). أما إذا حاولت خيوط متعددة الوصول إلى عناوين مختلفة في نفس البنك، يتم تسلسل الطلبات ويحدث تأخير (تعارض البنك). لتجنب هذا، تُستخدم تقنيات مثل “الحشو” في الخوارزميات.
ملحق الفصل 4: خط أنابيب عمليات الضرب والجمع في نوى Tensor
نوى Tensor هي أجهزة ثورية سرعت من أداء معالجات الرسوميات للذكاء الاصطناعي والتعلم العميق بشكل كبير.
4.1 التنفيذ المادي لعمليات ضرب وجمع المصفوفات (MMA)
معظم الحسابات في التعلم العميق هي ضرب المصفوفات ($D = A \times B + C$). خلافاً لنوى CUDA التقليدية التي تحسب عنصرًا بعنصر، فإن نوى Tensor هي دوائر مخصصة تنفذ عمليات الضرب والجمع لمصفوفات صغيرة في دورة واحدة (أو دورات قليلة). بهذا، تكون إنتاجية الحساب أعلى بكثير من نوى CUDA العادية.
4.2 سر الدقة المختلطة (Mixed-Precision)
ميزة مهمة في نوى Tensor هي دعم الدقة المختلطة. يتم قراءة المصفوفات وإجراء الضرب بدقة منخفضة (مثل FP16، FP8، INT8)، ثم يتم إجراء عملية الجمع بدقة أعلى (مثل FP32).
- FP16 / BF16: المعيار للتدريب.
- FP8 / INT8 / INT4: الورقة الرابحة لتسريع الاستدلال.
ملحق الفصل 5: تسلسل ذاكرة CUDA وتقنيات التحسين
مهما زادت قوة معالج الرسوميات، يصبح الأداء محدودًا إذا لم يتم توفير البيانات بالسرعة الكافية (مشكلة جدار الذاكرة). 90٪ من تحسين CUDA هو “تحسين الوصول إلى الذاكرة”.
5.1 الوصول المدمج للذاكرة العامة (Coalescing)
تتمتع الذاكرة العامة بنطاق ترددي واسع جدًا ولكن بزمن انتقال كبير. المبدأ الأساسي لتحسين الوصول إليها هو الدمج (Coalescing). عندما تصل 32 خيطًا في Warp إلى عناوين ذاكرة متتالية، تدمج الأجهزة هذه الطلبات في معاملة ذاكرة واحدة. الوصول غير المدمج (عناوين عشوائية أو متباعدة) يقلل الأداء بشكل كارثي.
5.2 مثال كود CUDA C++: تحسين تبديل المصفوفة والذاكرة المشتركة
فيما يلي مثال على كود نواة محسّن لتبديل المصفوفات (Matrix Transpose):
| |
النقاط الرئيسية هي:
- الدمج عند القراءة.
- الدمج عند الكتابة.
- الحشو في الذاكرة المشتركة لتجنب تعارض البنوك.
5.3 تسلسل التخزين المؤقت والذواكر الخاصة
- سياسة ذاكرة التخزين المؤقت L1/L2: في بنيات معالجات الرسوميات الحديثة، يمكن للمبرمجين التحكم في سلوك ذاكرة التخزين المؤقت.
- ذاكرة النسيج / الذاكرة الثابتة: تتمتع الذاكرة الثابتة بكفاءة عالية جدًا في الوصول بالبث للثوابت.
ملحق الفصل 6: مستقبل معالجات الرسوميات في عصر التعلم العميق
6.1 التوصيل البيني فائق السرعة عبر NVLink و NVSwitch
لا تتسع نماذج اللغة الكبيرة في ذاكرة معالج رسوميات واحد. طورت NVIDIA NVLink و NVSwitch لربط العديد من معالجات الرسوميات كمعالج واحد ضخم لتمكين نقل البيانات بسرعة عالية.
6.2 محرك Transformer ونظام FP8 البيئي
لتحسين بنية Transformer، تمت إضافة Transformer Engine لتبديل دقة الحساب ديناميكيًا بين FP8 و FP16 مما يوفر أعلى سرعة حسابية بدون التضحية بالدقة.
6.3 قوانين التوسع في مجموعات معالجات الرسوميات وآفاق المستقبل
كما تشير قوانين التوسع، كلما زاد الحجم، زاد أداء الذكاء الاصطناعي. تتطور معالجات الرسوميات من مجرد شرائح لتصبح مراكز بيانات كاملة تعمل كـ “كمبيوتر فائق واحد”. مستقبل التطور سيشمل تقنيات الاتصال البصري والتكديس ثلاثي الأبعاد، ولكن هدف “تحقيق أعلى إنتاجية بالتوازي” سيبقى ثابتًا.
الخاتمة: نحو آفاق العلوم الحسابية
بنية وحدة معالجة الرسومات هي المحرك الحسابي الأكثر تعقيدًا وتخصصًا في الإنتاجية الذي ابتكره البشر على الإطلاق. إذا كانت وحدة المعالجة المركزية (CPU) هي “سيارة فورمولا 1 فائقة الأداء”، فإن وحدة معالجة الرسومات (GPU) هي “نظام لوجستي ضخم حيث تقوم عشرات الآلاف من الشاحنات القلابة بنقل الإمدادات في وقت واحد بحركة منسقة”.
إن تنفيذ التعليمات بوحدة Warp بواسطة SIMT، والجدولة التي تبدل آلاف الخيوط في دورة صفرية، والوصول المدمج لزيادة النطاق الترددي إلى أقصى حد، وخط أنابيب نوى Tensor، كلها تجسيد لهوس المهندسين بـ “كيفية تعظيم إجمالي عدد حسابات الفاصلة العائمة ضمن حدود قوانين الفيزياء”.
فهم بنية وحدة معالجة الرسومات ليس مجرد ثقافة عامة لمهندسي البرمجيات والباحثين، بل هو “مادة إجبارية” لاستخراج قدرات الأجهزة إلى أقصى حد. المستقبل حيث يتم إنجاز الحسابات التي كانت تستغرق شهورًا على أجهزة الكمبيوتر الفائقة في بضع ساعات باستخدام عدة وحدات معالجة رسومات هو حقيقة واقعة الآن.
نحن نعيش الآن العصر الذهبي لأكثر بنيات الحوسبة إثارة في تاريخ البشرية. من خلال فهم فيزياء CUDA والجوهر الحقيقي للبنية فائقة التوازي لوحدة معالجة الرسومات، قد تكون أنت من يخلق الابتكار القادم.
مسرد المصطلحات (Glossary)
- SM (المعالج المتعدد المتدفق): وحدة المعالجة الرئيسية في وحدة معالجة الرسومات. تعادل النواة في وحدة المعالجة المركزية، ولكنها تحتوي على العديد من نوى CUDA، ومجدول Warp، والذاكرة المشتركة وما إلى ذلك.
- SIMT (تعليمة مفردة، خيوط متعددة): نموذج التنفيذ الخاص بوحدات معالجة الرسومات، حيث تشارك جميع الخيوط في Warp نفس التعليمة بينما تقوم بعمليات حسابية على بيانات مستقلة.
- Warp (التفاف): مجموعة من 32 خيطًا. وهي أصغر وحدة لجدولة الأجهزة وإصدار التعليمات.
- Warp Divergence (تباين Warp): ظاهرة يحدث فيها اختلاف في شروط التفرع بين الخيوط داخل Warp، مما يؤدي إلى تسلسل مسارات التنفيذ وتقليل الإنتاجية.
- Tensor Core (نواة Tensor): دائرة مخصصة تعالج عمليات ضرب وجمع المصفوفات دفعة واحدة على مستوى الأجهزة، وهي مخصصة لتسريع التعلم العميق.
- Coalesced Access (الوصول المدمج): آلية حيث عندما تصل الخيوط في Warp إلى عناوين ذاكرة متتالية، تقوم الأجهزة بدمجها في معاملة واحدة لتحقيق نطاق ترددي عالٍ.
- Shared Memory (الذاكرة المشتركة): ذاكرة L1 سريعة جدًا مدمجة داخل SM ويمكن للمبرمج التحكم فيها.
- Bank Conflict (تعارض البنك): عقوبة تحدث في الذاكرة المشتركة عندما تحاول خيوط متعددة الوصول إلى عناوين مختلفة في نفس البنك في نفس الوقت، مما يؤدي إلى تسلسل الوصول.
- Occupancy (الإشغال): النسبة الفعلية مقارنة بالحد الأقصى النظري لعدد Warps التي يمكن أن تكون نشطة في نفس الوقت على SM.
- Register Spilling (تسريب السجل): ظاهرة حيث يتجاوز عدد السجلات التي يستخدمها الخيط الحد المسموح به للأجهزة، مما يؤدي إلى تسريب البيانات الفائضة إلى ذاكرة محلية أبطأ.
المراجع وقائمة القراءة الموصى بها
- دليل برمجة NVIDIA CUDA C++: وثيقة رسمية يجب على كل مبرمج CUDA قراءتها. تغطي أنماط الوصول إلى الذاكرة وأفضل ممارسات التحسين.
- ورقة عمل بنيات NVIDIA Ampere / Hopper: ورقة عمل رسمية تصف تفاصيل خط أنابيب Tensor Core، وعمليات النقل غير المتزامنة للذاكرة، وتطبيق أجهزة محرك Transformer.
- هندسة الكمبيوتر: نهج كمي (John L. Hennessy, David A. Patterson): كتاب كلاسيكي عظيم في هندسة الكمبيوتر. يعلم بعمق الاختلافات في فلسفات التصميم بين CPU و GPU والتسلسل الهرمي للذاكرة.
- برمجة المعالجات المتوازية الضخمة: نهج عملي (David B. Kirk, Wen-mei W. Hwu): كتاب مدرسي يشرح برمجة CUDA من منظور تصميم الخوارزمية.
- تشريح بنية NVIDIA Volta GPU عبر المعايير الدقيقة: ورقة بحثية تكشف أسرار الكمون للذاكرة المؤقتة وإنتاجية Tensor Core الدقيقة باستخدام معايير دقيقة لم يتم نشرها رسميًا.
قد تصبح المعرفة بالبنية المعمارية الموضحة في هذا المقال قديمة مع تطور الأجهزة، ولكن المبدأ المادي الأساسي المتمثل في “الحد الأقصى للنطاق الترددي، واستخراج التوازي، وإخفاء زمن الانتقال” سيظل حقيقة عالمية في علوم الكمبيوتر.