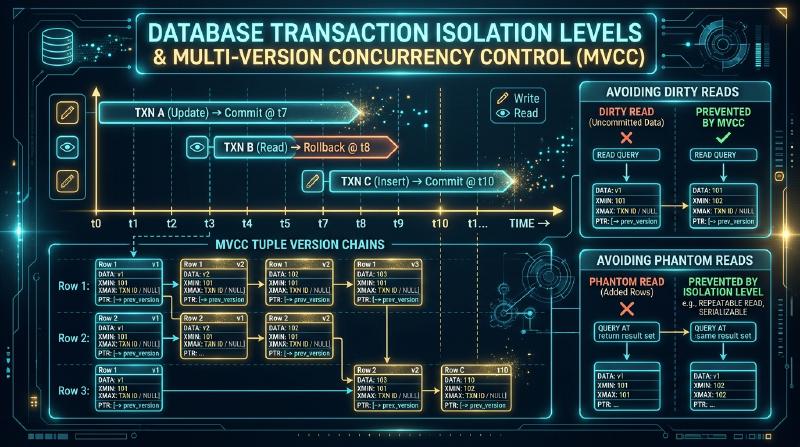
مستويات عزل معاملات قواعد البيانات وMVCC: حقيقة ACID والتحكم المتزامن متعدد الإصدارات
في بنية البرمجيات الحديثة، لا تزال أنظمة إدارة قواعد البيانات العلائقية (RDBMS) حجر الزاوية في استمرارية البيانات. وفي قلبها يكمن مفهوم “المعاملة” (Transaction)، وخصائص ACID (الذرية، الاتساق، العزل، المتانة) على وجه الخصوص معترف بها على نطاق واسع كنظرية أساسية لبناء أنظمة قوية. ومع ذلك، من بين خصائص ACID، فإن “العزل” (Isolation) هو المجال الذي توجد فيه أكبر فجوة بين النظرية والتطبيق.
في هذا المقال، سنتعمق من منظور أكاديمي وعملي مفصل للغاية، بدءًا من الخلفية التاريخية لمستويات عزل معاملات قواعد البيانات، مرورًا بحدود معيار ANSI SQL-92، وصولاً إلى البنية الداخلية لـ Multi-Version Concurrency Control (MVCC: التحكم المتزامن متعدد الإصدارات) الذي تتبناه محركات قواعد البيانات الحديثة. بشكل خاص، سنقوم بتحليل الاختلافات الحاسمة في تنفيذ MVCC بين اثنين من أكبر أنظمة إدارة قواعد البيانات مفتوحة المصدر: PostgreSQL وMySQL (InnoDB)، ونغطي أحدث ما توصلت إليه قواعد البيانات الموزعة: Serializable Snapshot Isolation (SSI). نقدم لك هذا العمل الضخم الذي يتجاوز 12,000 حرف.
الفصل الأول: أسطورة خصائص ACID ومعضلة المعالجة المتزامنة
1.1 مثالية القابلية للتسلسل (Serializability)
الشكل المثالي النهائي الذي يهدف إليه “العزل” (Isolation) في المعاملات هو “القابلية للتسلسل” (Serializability). يشير هذا إلى الخاصية التي تضمن أنه حتى في حالة تنفيذ عدة معاملات بشكل متزامن، فإن نتيجة التنفيذ “تكون مكافئة لنتيجة تنفيذ المعاملات بشكل تسلسلي (واحدة تلو الأخرى) بترتيب ما”.
عندما يتم تنفيذ المعاملتين $T_1$ و $T_2$ في نفس الوقت على النظام، بغض النظر عن كيفية حدوث التداخل (Interleaving) بسبب التنفيذ المتزامن، إذا كانت الحالة النهائية لقاعدة البيانات تتطابق تمامًا مع نتيجة التنفيذ بترتيب “$T_1 \rightarrow T_2$” أو “$T_2 \rightarrow T_1$"، فإن هذا الجدول الزمني (Schedule) يُعرّف بأنه قابل للتسلسل. إذا تم ضمان هذه القابلية للتسلسل، يمكن لمطوري التطبيقات التركيز على بناء منطق الأعمال دون الحاجة إلى القلق على الإطلاق بشأن عدم اتساق البيانات (مثل ظروف السباق أو الاستبدال غير المناسب) الناجم عن المعالجة المتزامنة.
1.2 انهيار الأداء بسبب التسلسل عبر الأقفال (Locks)
في أنظمة قواعد البيانات المبكرة، لضمان هذه القابلية للتسلسل، تم اعتماد آلية قفل صارمة تسمى “القفل ثنائي الطور” (2PL: Two-Phase Locking). في 2PL، يجب على المعاملة دائمًا الحصول على قفل (قفل مشترك أو قفل حصري) قبل قراءة البيانات أو كتابتها (المرحلة 1: Growing Phase)، وتحرير جميع الأقفال عند انتهاء المعاملة (عند الالتزام أو التراجع) (المرحلة 2: Shrinking Phase).
ومع ذلك، كانت هناك عيوب قاتلة في آلية القفل الصارمة هذه. إنها “تدهور الأداء الشديد”.
- عمليات القراءة تعيق (Block) عمليات الكتابة.
- عمليات الكتابة تعيق عمليات القراءة.
- زيادة أوقات الانتظار بسبب التنافس على الأقفال، وتكرار حدوث حالة الجمود (Deadlock).
مع زيادة حركة المرور والوصول المتزامن لعدد كبير من المستخدمين إلى قاعدة البيانات، أصبح التسلسل الكامل باستخدام 2PL عنق الزجاجة للنظام، وانخفضت الإنتاجية (Throughput) بشكل حاد. واجهت الأنظمة معضلة المقايضة بين “اتساق البيانات” و"أداء المعالجة المتزامنة (الإنتاجية)”.
1.3 تاريخ التحكم المتزامن والتسويات
لحل هذه المعضلة، أدخل باحثو هندسة قواعد البيانات مفهوم “مستوى العزل” (Isolation Level). هذا “نتاج تسوية” يخفف جزئيًا من القابلية للتسلسل الكاملة ويحسن أداء المعالجة المتزامنة على حساب السماح بحدوث بعض حالات عدم اتساق البيانات (الشذوذ: Anomaly). بناءً على متطلبات التطبيق، أصبح من الممكن اختيار التوازن بين الاتساق والأداء.
الفصل الثاني: مستويات العزل في معيار ANSI SQL-92 والانتقادات الموجهة لها
2.1 تعريف مستويات العزل في معيار ANSI SQL-92
في معيار SQL “SQL-92” الذي تم إنشاؤه في عام 1992، تم تعريف 4 مستويات عزل بناءً على 3 ظواهر شاذة (Phenomena) رئيسية يمكن أن تحدث بسبب المعالجة المتزامنة.
الظواهر الشاذة الثلاث المحددة
- القراءة القذرة (Dirty Read): ظاهرة تقوم فيها المعاملة $T_1$ بتحديث البيانات وقبل الالتزام (Commit)، تقوم معاملة أخرى $T_2$ بقراءة تلك البيانات غير الملتزم بها. إذا تراجعت (Rollback) المعاملة $T_1$، فإن $T_2$ تكون قد قرأت بيانات وهمية لا وجود لها.
- القراءة غير القابلة للتكرار (Non-repeatable Read): ظاهرة حيث تقوم المعاملة $T_1$ بقراءة نفس الصف مرتين، وفي هذه الأثناء، تقوم معاملة أخرى $T_2$ بتحديث ذلك الصف والالتزام به. ستكون نتيجة القراءة الأولى والثانية لـ $T_1$ مختلفة.
- القراءة الوهمية (Phantom Read): ظاهرة حيث تقوم المعاملة $T_1$ بقراءة عدة صفوف بشرط بحث معين، وفي هذه الأثناء، تقوم معاملة أخرى $T_2$ بإدراج (أو حذف) صف جديد يطابق ذلك الشرط والالتزام به. إذا قامت $T_1$ بالبحث مرة أخرى بنفس الشرط، سيزيد أو ينقص عدد الصفوف.
مستويات العزل الأربعة حسب SQL-92
حدد SQL-92 مستويات العزل وفقًا لدرجة منع حدوث هذه الظواهر الشاذة.
- Read Uncommitted: يسمح بالقراءة القذرة.
- Read Committed: يمنع القراءة القذرة، لكنه يسمح بالقراءة غير القابلة للتكرار والقراءة الوهمية.
- Repeatable Read: يمنع القراءة القذرة والقراءة غير القابلة للتكرار، لكنه يسمح بالقراءة الوهمية.
- Serializable: يمنع جميع الظواهر الشاذة ويضمن القابلية للتسلسل الكاملة.
2.2 ورقة النقد لبيرنسون وآخرين “A Critique of ANSI SQL Isolation Levels”
يبدو تعريف معيار SQL-92 للوهلة الأولى واضحًا ومنطقيًا للغاية. ومع ذلك، فإن الورقة البحثية “A Critique of ANSI SQL Isolation Levels” التي نُشرت عام 1995 من قبل عمالقة قواعد البيانات Hal Berenson وJim Gray (الفائز بجائزة تورينج) وPhil Bernstein وآخرين، وجهت ضربة قاضية لتعريف معيار ANSI هذا.
العيوب الرئيسية في معيار SQL-92 التي أشارت إليها هذه الورقة هي كما يلي:
1. الافتراض الضمني القائم على الأقفال
كان تعريف SQL-92 يفترض ضمنيًا أن “قاعدة البيانات منفذة باستخدام التحكم المتزامن القائم على الأقفال (2PL)”. ومع ذلك، في التسعينيات، كانت قواعد البيانات التي تعتمد MVCC (الموضح لاحقًا) وغيرها من أساليب التحكم المتزامن المتفائل (OCC) قد بدأت بالفعل في الظهور، وأصبح تعريف الشذوذ القائم على الأقفال قديمًا.
2. الغموض والنقص في التعريف
تمت الإشارة إلى أن الظواهر الشاذة الثلاث (Dirty Read, Non-repeatable Read, Phantom Read) المحددة في SQL-92 ليست كافية لتغطية جميع الظواهر الشاذة التي قد تحدث في المعالجة المتزامنة. على سبيل المثال، هناك ظاهرة “الكتابة القذرة (Dirty Write)”. هذه ظاهرة حيث يتم الكتابة فوق البيانات التي كتبتها معاملة غير ملتزم بها بواسطة معاملة أخرى غير ملتزم بها أيضًا، ولكن لا يوجد ذكر للكتابة القذرة في معيار SQL-92. على الرغم من أن جميع مستويات العزل (بما في ذلك Read Uncommitted) يجب أن تمنع الكتابة القذرة (وإلا سينهار الاتساق الداخلي لقاعدة البيانات)، إلا أن المعيار لم يتطرق إلى هذه النقطة.
3. اكتشاف ظواهر شاذة جديدة
في الورقة، تم تعريف عدة ظواهر شاذة جديدة لم تكن موجودة في معيار SQL-92. وأبرزها اثنتان:
- التحديث المفقود (Lost Update): ظاهرة تقرأ فيها معاملتان نفس البيانات في نفس الوقت، وعندما تقوم كل منهما بكتابة نتيجة الحساب، تقوم تحديثات إحداهما بالكتابة فوق تحديثات الأخرى وتمحوها.
- انحراف الكتابة (Write Skew): ظاهرة خاصة بعزل اللقطة (Snapshot Isolation) سيتم شرحها لاحقًا.
أثبتت ورقة بيرنسون وآخرين أن معيار SQL-92 لم يتمكن من تعريف مستويات العزل رياضيًا وبشكل صارم، مما أحدث صدمة كبيرة في صناعة قواعد البيانات. في نظرية قواعد البيانات الحالية، يُعامل تعريف مستويات العزل الخاص بـ ANSI SQL-92 على أنه “شيء يجب تعلمه كخلفية تاريخية” وأنه “غير كافٍ كتعريف تقني صارم”.
الفصل الثالث: عزل اللقطة (Snapshot Isolation) وانحراف الكتابة
3.1 الفرق بين Repeatable Read وعزل اللقطة
ما لفت الانتباه بشكل خاص في ورقة بيرنسون وآخرين هو اقتراح مستوى عزل جديد يسمى “عزل اللقطة (Snapshot Isolation: SI)”.
في العديد من قواعد البيانات التي تعتمد MVCC (مثل PostgreSQL و Oracle)، فإن حقيقة مستوى العزل المقدم كـ “Repeatable Read” هي في الواقع “عزل اللقطة”. في عزل اللقطة، تقوم كل معاملة بقراءة من “لقطة (حالة ثابتة سابقة)” متسقة لقاعدة البيانات في وقت بدء المعاملة.
- لا يمكن رؤية التحديثات التي تمت بواسطة معاملات أخرى بعد وقت بدء المعاملة على الإطلاق (منع القراءة غير القابلة للتكرار).
- نظرًا لأن وجود السجل بحد ذاته ثابت عند نقطة سابقة في الوقت، لا يمكن رؤية عمليات الإدراج (INSERT) من قبل المعاملات الأخرى أيضًا (منع القراءة الوهمية).
بمعنى آخر، لا يلبي عزل اللقطة متطلبات “Repeatable Read” المعرفة بواسطة SQL-92 فحسب، بل إنه يمنع في كثير من الحالات “القراءة الوهمية” أيضًا. إذن، هل عزل اللقطة مكافئ لـ “Serializable”؟ الجواب هو “لا”. لأن عزل اللقطة يحتوي على ظاهرة شاذة قاتلة غير قابلة للتسلسل تُسمى “انحراف الكتابة (Write Skew)”.
3.2 مشكلة الطبيب المناوب (On-Call) وانحراف الكتابة (Write Skew)
المثال الأكثر شهرة لفهم انحراف الكتابة هو “نظام الطبيب المناوب”.
【قاعدة العمل】 لنفترض أن هناك نظامًا لإدارة نوبات المستشفى ولديه قاعدة تنص على أنه “يجب أن يكون هناك طبيب واحد على الأقل دائمًا في حالة مناوبة (on-call)”.
حاليًا، الطبيبان أليس (Alice) وبوب (Bob) في حالة مناوبة (on_call = true).
في هذا الوقت، فكر كل من أليس وبوب صدفة في نفس الوقت “أشعر بالمرض وأريد الخروج من المناوبة”، وبدآ في تنفيذ معاملة تغيير النوبة من أجهزتهما.
【سير المعاملة (في ظل عزل اللقطة)】
- [Tx1: Alice] الحصول على لقطة. تأكيد أن هناك طبيبين مناوبين حاليًا وهما أليس وبوب.
SELECT count(*) FROM doctors WHERE on_call = true;-> النتيجة: 2 - [Tx2: Bob] الحصول على لقطة. تأكيد أن هناك طبيبين أيضًا وهما أليس وبوب.
SELECT count(*) FROM doctors WHERE on_call = true;-> النتيجة: 2 - [Tx1: Alice] 판단 أن القاعدة (طبيب مناوب واحد أو أكثر) مستوفاة، وتقوم بإزالة نفسها من المناوبة.
UPDATE doctors SET on_call = false WHERE name = 'Alice'; - [Tx2: Bob] 판단 أن القاعدة مستوفاة أيضًا، ويقوم بإزالة نفسه من المناوبة.
UPDATE doctors SET on_call = false WHERE name = 'Bob'; - [Tx1: Alice] تم الالتزام بنجاح.
- [Tx2: Bob] تم الالتزام بنجاح. (نظرًا لأن أليس وبوب يقومان بتحديث سجلات مختلفة، فلا يوجد تنازع على قفل الصف)
【النتيجة】 نتيجة لالتزام كل من Tx1 و Tx2، أصبح عدد الأطباء المناوبين “0”. لقد انهارت قاعدة العمل.
هذا هو انحراف الكتابة (Write Skew). إذا كان قابلاً للتسلسل (Serializable)، فسيتم التنفيذ التسلسلي لـ Tx1 أو Tx2 أولاً، وبالتالي فإن المعاملة التي تم تنفيذها لاحقًا ستكتشف أن عدد المناوبين هو “1” وكان بإمكانها إحباط (تراجع) عملية إزالة نفسها. ومع ذلك، في عزل اللقطة، نظرًا لأنهما يقومان بتحديث صفوف بيانات مختلفة (صف أليس وصف بوب)، لم يتم اكتشاف التصادم، مما يتسبب في عدم اتساق في قواعد العمل.
3.3 شذوذ القراءة فقط (ReadOnly Anomaly)
علاوة على ذلك، يحتوي عزل اللقطة أيضًا على ظاهرة شاذة خاصة جدًا تُسمى ReadOnly Anomaly، حيث تنهار القابلية للتسلسل بتدخل “معاملة قراءة فقط”. هذه الظاهرة، التي تظهر في أمثلة مثل رصيد الحساب المصرفي ومنح الفوائد، هي ظاهرة حيث لا يحدث تنازع بين معاملات التحديث، لكن معاملة القراءة فقط تنظر إلى لقطة سابقة وتقرأ “حالة لجدول زمني غير ممكنة منطقيًا”. بسبب وجود هذه الظواهر الشاذة، يتم تمييز عزل اللقطة عن Serializable بالمعنى الدقيق.
الفصل الرابع: مبادئ عمل MVCC (التحكم المتزامن متعدد الإصدارات)
لقد ناقشنا حتى الآن نظرية مستويات العزل والظواهر الشاذة، ولكن كيف تتحكم قواعد البيانات الحديثة في ذلك؟ التكنولوجيا الأساسية هي MVCC (Multi-Version Concurrency Control: التحكم المتزامن متعدد الإصدارات).
4.1 “القراءة لا تعيق الكتابة، والكتابة لا تعيق القراءة”
فلسفة التصميم الكبرى لـ MVCC، والفرق الحاسم بينه وبين التحكم القائم على الأقفال (2PL)، هو “أن القراءة والكتابة لا يعيقان (Block) بعضهما البعض”. عند تحديث سجل، لا تقوم قاعدة بيانات MVCC بالكتابة فوق السجل الموجود مباشرة (In-place update). بدلاً من ذلك، تقوم بإنشاء إصدار جديد من السجل (إصدار / صف-Tuple) وتحتفظ بالإصدار القديم في نفس الوقت.
ستتواجد عدة إصدارات من نفس السجل (التاريخ من الماضي إلى الحاضر) في قاعدة البيانات في وقت واحد. عندما تقوم معاملة بقراءة بيانات، فإنها تحسب وتقرأ “الإصدار القديم الصحيح الذي يجب أن تقرأه” من بين الإصدارات العديدة الموجودة في النظام بناءً على “معرف المعاملة (XID)” الخاص بها أو “وقت البدء (Timestamp)”.
بفضل ذلك، حتى إذا كانت إحدى المعاملات في منتصف عملية إعادة كتابة سجل، يمكن للمعاملات الأخرى قراءة “الإصدار القديم قبل إعادة الكتابة”، وتجنب الانتظار بسبب الأقفال.
4.2 سلسلة إدارة إصدارات الصفوف وقواعد الرؤية (Visibility)
الخوارزمية الأكثر أهمية في MVCC هي قاعدة الرؤية (Visibility Rule)، التي تحدد “أي معاملة يمكنها رؤية أي إصدار من البيانات”.
يتم تخصيص معرف معاملة فريد يتزايد بشكل مطرد (XID) لكل معاملة عند البدء. يُمنح كل إصدار (صف) من السجل المخزن في قاعدة البيانات المعلومات التالية كبيانات وصفية (Metadata):
- XID الإنشاء: معرف المعاملة التي أنشأت هذا الإصدار بواسطة INSERT/UPDATE.
- XID الحذف: معرف المعاملة التي حذفت هذا الإصدار منطقيًا (أبطلته) بواسطة UPDATE/DELETE.
عندما تقرأ المعاملة $T_i$ صف بيانات، فإنها تحدد الرؤية بناءً على القواعد الأساسية التالية:
- هل تم الالتزام بها؟: هل تم بالفعل الالتزام بالمعاملة الخاصة بـ XID الإنشاء؟
- أليست في المستقبل؟: هل XID الإنشاء يخص معاملة حدثت قبل وقت بدء $T_i$؟
- ألم يتم حذفها؟: ألم يتم تعيين XID الحذف، أو لم يتم الالتزام بمعاملة XID الحذف بعد، أو هل هي معاملة في المستقبل بالنسبة لوقت بدء $T_i$؟
من خلال تقييم هذه الشروط بصرامة، يتم توفير لقطة متسقة لكل معاملة.
الفصل الخامس: الاختلافات الحاسمة في تنفيذ MVCC بين PostgreSQL و MySQL (InnoDB)
على الرغم من أن المبدأ الأساسي لـ MVCC هو نفسه، إلا أن التنفيذ الداخلي يختلف بشكل مدهش اعتمادًا على منتج قاعدة البيانات. هنا، سنقوم بتحليل ومقارنة بنية MVCC في PostgreSQL و MySQL (InnoDB)، وهما عملاقا عالم المصادر المفتوحة.
5.1 تنفيذ MVCC في PostgreSQL: الإضافة في الكومة (Heap) وضرورة VACUUM
يعتمد MVCC في PostgreSQL “بنية الإضافة فقط (Append-only)” فريدة وبديهية للغاية.
5.1.1 منطق تقييم البت عبر xmin و xmax
داخل ملف البيانات (الكومة - Heap) الذي يمثل الكيان الفعلي لجدول PostgreSQL، يتم تسجيل معرفي معاملة هما xmin و xmax في ترويسة كل صف (Tuple).
xmin(Transaction ID of Insert): معرف المعاملة XID التي أنشأت هذا الصف.xmax(Transaction ID of Delete): معرف المعاملة XID التي حذفت هذا الصف (أو الحذف المنطقي للإصدار القديم بسبب التحديث).
【سلوك عملية UPDATE】
في PostgreSQL، تتم معالجة UPDATE منطقيًا كمجموعة من DELETE و INSERT.
- كتابة XID للمعاملة الحالية في
xmaxللصف القديم. (حذف منطقي) - إنشاء صف جديد تمامًا في المنطقة الفارغة من الكومة، وكتابة البيانات الجديدة، وتعيين
xminإلى XID للمعاملة الحالية. (إضافة جديدة)
بمعنى آخر، يتم تخزين كل من الصفوف القديمة والجديدة معًا في نفس ملف بيانات الجدول (الكومة).
5.1.2 الفوائد الهائلة والتحديات القاتلة: وجود VACUUM
الميزة الأكبر لهذه البنية هي أن التراجع (Rollback) سريع للغاية. إذا تم إحباط معاملة، يكفي معاملة الصف المضاف كـ “غير ملتزم به”، ولا حاجة إلى عملية التراجع عن البيانات (الكتابة العكسية).
ومع ذلك، كتحدي قاتل، هناك “تضخم الصفوف الميتة (Dead Tuples)”.
إذا كررت UPDATE أو DELETE، فإن الإصدارات القديمة من الصفوف التي لم يعد أحد يشير إليها (الصفوف التي يحتوي xmax الخاص بها على معرف معاملة قديم وملتزم به) ستتراكم بلا حدود في الكومة. إذا ترك هذا دون معالجة، سيتضخم الحجم المادي للجدول بشكل انفجاري، وينهار أداء الفحص التسلسلي (Sequential Scan) بشكل مدمر.
عملية النظام لحذف هذه الصفوف غير الضرورية ماديًا وجعل المساحة الفارغة قابلة لإعادة الاستخدام هي VACUUM (وبرنامج الخفي autovacuum الذي يعمل تلقائيًا). السبب الذي يجعل ضبط VACUUM مهمًا للغاية في تشغيل PostgreSQL يعود إلى جوهر بنية MVCC هذه.
5.2 تنفيذ MVCC في MySQL InnoDB: التحديث الموضعي وإعادة البناء الديناميكي لسجل التراجع (Undo Log)
من ناحية أخرى، يعتمد InnoDB، محرك التخزين الافتراضي لـ MySQL، بنية أقرب إلى Oracle Database تتمثل في “التحديث الموضعي (In-place update) وسجل التراجع (Undo Log/Rollback Segment)”.
5.2.1 الفهرس العنقودي (Clustered Index) والتحديث الموضعي
تتكون جداول InnoDB كـ B+Tree (فهرس عنقودي) يعتمد على المفتاح الأساسي.
عند تنفيذ UPDATE في InnoDB، بدلاً من إلحاق صف جديد مثل PostgreSQL، فإنه يقوم بالكتابة فوق صف البيانات في B+Tree مباشرة (In-place update).
إذن، ماذا لو أرادت المعاملات الأخرى قراءة لقطة سابقة؟ للقيام بذلك، يقوم InnoDB بترحيل “البيانات القديمة” قبل الكتابة فوقها إلى منطقة مخصصة تسمى سجل التراجع (Undo Log Segment).
5.2.2 إعادة البناء الديناميكي للماضي باستخدام مؤشر التراجع (Roll Pointer)
يحتوي العمود المخفي لكل صف بيانات في InnoDB على الاثنين التاليين:
DB_TRX_ID: معرف المعاملة التي قامت بإدراج هذا الصف أو تحديثه آخر مرة.DB_ROLL_PTR(Roll Pointer): مؤشر يشير إلى الموقع في سجل التراجع حيث يتم حفظ “الإصدار الأقدم خطوة واحدة” من هذا الصف.
عملية قراءة معاملة للقطة سابقة هي كما يلي:
- قراءة أحدث صف بيانات من B+Tree.
- التحقق من
DB_TRX_ID، وإذا كان التحديث بواسطة معاملة مستقبلية بالنسبة للقطة الخاصة بها، فإنها تقرر أنه يجب عدم قراءة هذا الصف الأحدث. - تتبع
DB_ROLL_PTRوالحصول على بيانات الإصدار القديم من سجل التراجع. - استخدام البيانات الموجودة في سجل التراجع، إعادة بناء حالة السجل السابقة ديناميكيًا (Rollback in memory) في الذاكرة.
- إذا كان لا يزال تحديثًا مستقبليًا، فإنها تتبع سلسلة سجل التراجع بشكل أعمق إلى الماضي.
5.2.3 فوائد وتحديات InnoDB
ميزة هذه البنية هي أنه من الصعب أن تتضخم مساحة الجدول الرئيسية (Tablespace). توجد أحدث البيانات دائمًا في الموضع المناسب في B+Tree، ويتم عزل الإصدارات القديمة في منطقة أخرى (سجل التراجع)، وبالتالي يتم الحفاظ على كفاءة المسح المادي عالية (لا حاجة إلى VACUUM واسع النطاق كما في PostgreSQL، وتعمل عملية تطهير سجل التراجع بخفة في الخلفية).
من ناحية أخرى، العيب هو أنه في حالة وجود معاملات طويلة الأمد تقرأ كمية كبيرة من اللقطات السابقة (مثل المعالجة الدفعية أو mysqldump)، ينشأ عبء تتبع سجل التراجع بعمق لإعادة بناء البيانات، مما يقلل من أداء القراءة. كما أن هناك خطر يتمثل في أن سجل التراجع نفسه قد يتضخم ويضغط على مساحة القرص.
الفصل السادس: عزل اللقطة القابل للتسلسل (SSI) وطليعة قواعد البيانات الموزعة
لا يتوقف تطور MVCC هنا. كما هو موضح في الفصل الثالث، يحتوي عزل اللقطة (SI) على ظواهر شاذة مثل “انحراف الكتابة”، ولم يكن Serializable بالكامل. ولكن، من أجل عدم جعل مطوري التطبيقات على دراية بتعقيد المعالجة المتزامنة، من الضروري تحقيق Serializable الكامل مع الحفاظ على الأداء العالي لـ MVCC.
6.1 ولادة عزل اللقطة القابل للتسلسل (SSI)
في عام 2008، نُشرت خوارزمية ثورية تسمى “Serializable Snapshot Isolation (SSI)” في ورقة بحثية كتبها مايكل كاهيل وآخرون. إنها تقنية تضمن القابلية للتسلسل الكاملة (Serializable) معتمدة على بنية MVCC. اعتمدت PostgreSQL هذا الـ SSI مبكرًا بدءًا من الإصدار 9.1 كتنفيذ لمستوى العزل “Serializable”.
مبدأ عمل SSI: رسم بياني للتنازع وهيكل الخطر (rw-antidependency)
لا يعتمد SSI على الحظر بواسطة الأقفال. بدلاً من ذلك، فإنه يتتبع بدقة أثناء تنفيذ المعاملة “أي البيانات تم قراءتها (Read) وأي البيانات تم كتابتها (Write)”.
يقوم SSI بمراقبة علاقات التنازع بين المعاملات ويبحث عن نمط تنازع معين يسمى “rw-antidependency (الاعتماد المضاد للقراءة والكتابة)”. على وجه التحديد، هي علاقة حيث تقرأ المعاملة $T_1$ إصدارًا قديمًا من البيانات، وتقوم معاملة أخرى $T_2$ لاحقًا بالكتابة فوق تلك البيانات والالتزام بها. يقوم SSI داخليًا ببناء رسم بياني لتنازع المعاملات، وفي اللحظة التي يكتشف فيها “هيكلًا يتكون من سهمين متتاليين لـ rw-antidependency (هيكل الخطر)"، فإنه يحكم على أن القابلية للتسلسل قد تنهار، ويجبر إحدى المعاملات على الإحباط (Rollback).
يؤدي هذا إلى إيقاف المعاملات قبل حدوث ظواهر شاذة مثل انحراف الكتابة (مثل مشكلة الطبيب المناوب)، مما يضمن في النهاية نظام Serializable الكامل. يمكن القول إنه الشكل النهائي للتحكم المتزامن المتفائل (OCC).
6.2 MVCC في قواعد البيانات الموزعة: Spanner, CockroachDB, TiDB
تتجاوز تكنولوجيا قواعد البيانات الحديثة حدود الخادم الواحد وتتطور إلى قواعد بيانات SQL الموزعة (NewSQL) الموزعة عبر مراكز البيانات حول العالم. في بيئة موزعة، كان تحقيق MVCC متسق عالميًا تحديًا لقوانين الفيزياء.
Google Spanner و TrueTime API
قام Spanner من Google بتطوير TrueTime API لحل مشكلة ترتيب المعاملات في الأنظمة الموزعة. تحت فرضية أن ساعات (الساعات الفيزيائية) الخوادم تنحرف دائمًا (Clock Skew)، يجمع TrueTime بين نظام تحديد المواقع العالمي (GPS) والساعات الذرية، ويوفر الوقت الحالي كـ “نطاق لعدم اليقين (نافذة زمنية)”. من خلال انتظار مرور نافذة عدم اليقين لـ TrueTime عند الالتزام بالمعاملة (Commit Wait)، يضمن MVCC الخاص بـ Spanner فيزيائيًا أن “المعاملات ذات العلاقة السببية سيكون لها دائمًا ترتيب طابع زمني صحيح (الاتساق الخارجي / External Consistency)”.
CockroachDB و HLC (Hybrid Logical Clock)
تتبنى CockroachDB، وهي قاعدة بيانات موزعة مفتوحة المصدر مستوحاة من Spanner، HLC (الساعة المنطقية الهجينة) لتحقيق اتساق قريب من هذا دون استخدام الساعات الذرية الباهظة الثمن. من خلال الجمع بين مزامنة الساعة الفيزيائية بواسطة NTP وساعة لامبورت المنطقية (عداد يعتمد على العلاقة السببية بين الأحداث)، فإنه يولد طابعًا زمنيًا للقطة MVCC متسقًا عالميًا عبر العقد الموزعة، ويحقق SSI (Serializable Snapshot Isolation) في بيئة موزعة.
TiDB ونموذج Percolator
يتبنى TiDB، الذي تم تطويره بواسطة شركة PingCAP، نموذج معاملات موزعة يعتمد على نموذج Google Percolator. إنها بنية يتم فيها توفير مكون واحد يوزع الطوابع الزمنية العالمية (Placement Driver: PD)، ويستخدم محرك التخزين (TiKV) في كل عقدة هذا الطابع الزمني لمعالجة MVCC محليًا. على الرغم من اعتماده على 2PC (Two-Phase Commit)، فإنه يقلل من فترة الاحتفاظ بالقفل، ويجمع بين المعاملات الضخمة و MVCC في بيئة موزعة.
الخاتمة: إلى ما وراء ACID
مستويات عزل معاملات قواعد البيانات ليست مجرد عنصر للحفظ. إنها تاريخ من المعارك في علوم الكمبيوتر استمرت لعقود من الزمن حول كيفية التوفيق بين المتطلبات المتضاربة لاتساق البيانات وأداء النظام.
بدءًا من التعريف غير المكتمل لـ ANSI SQL-92، وصولاً إلى القفزة الهائلة في المعالجة المتزامنة بواسطة MVCC، وانقسام بنية PostgreSQL و InnoDB، وصولاً إلى التحدي المتمثل في الاتساق المطلق بواسطة SSI وقواعد البيانات الموزعة. يجب أن يكون الفهم العميق لهذه الهياكل الداخلية سلاحًا قويًا لتصميم تطبيقات أكثر قوة وعالية الأداء.
نحن نعيش الآن في عصر أصبحت فيه خصائص ACID ليست مجرد “أسطورة”، بل يتم تنفيذها كـ “حقيقة” من خلال الخوارزميات المتقدمة ومزامنة الساعات الفيزيائية. بالنسبة للمهندسين الذين يبحرون في بحر البيانات، فإن معرفة أعماق محركات قواعد البيانات هي رحلة استكشاف فكري لن تنتهي أبدًا.